Análisis de la Temperatura

Objetivos

Objetivo general

Estudiar e identificar la tendencia y los patrones espaciales del material particulado fino (PM2.5) y de la temperatura mediante el uso de herramientas de análisis geoestadístico, con el propósito de establecer modelos de predicción espacial que caractericen su comportamiento en el estado de Texas durante el año 2024.

Objetivos específicos

  • Analizar la estacionariedad en media de cada variable, estudiando la estructura de la media e identificando la existencia de dependencia espacial.
  • Construir el semivariograma empírico para PM2.5 y temperatura, y ajustar un modelo teórico que describa adecuadamente la estructura de variabilidad espacial.
  • Aplicar la técnica de Kriging para generar mapas de predicción espacial y mapas de incertidumbre, representando la distribución esperada de ambas variables y evaluando la precisión de las estimaciones obtenidas.

Descripción de las variables

Se utilizarán dos variables provenientes de la red de monitoreo de calidad del aire y condiciones meteorológicas del estado de Texas durante el año 2024:

  • Ozono (O\(_3\)):
    Variable: Daily Max 8-hour Ozone Concentration, que corresponde al máximo promedio móvil de 8 horas de ozono reportado diariamente por cada estación de monitoreo.
    • Unidad: partes por millón (ppm).
    • Escala: Razón (el valor cero indica ausencia total de ozono; se dice que una estación excede los niveles de O\(_3\) cuando la concentración máxima registrada en el promedio móvil de 8 horas supera los 0.070 ppm).
  • Material Particulado Fino (PM2.5):
    Variable: Daily Mean PM2.5 Concentration, que corresponde al promedio diario de concentración de partículas finas menores o iguales a 2.5 µm registradas por cada estación.
    • Unidad: microgramos por metro cúbico (µg/m³).
    • Escala: razón. Se considera un nivel elevado cuando la concentración diaria supera los 35 µg/m³, según la EPA.
  • Temperatura:
    Variable: Daily Mean Temperature, que corresponde al promedio diario de la temperatura ambiental registrada en cada estación meteorológica.
    • Unidad: grados Celsius (°C).
    • Escala: intervalo (no posee cero absoluto en °C, pero las diferencias entre valores son interpretables).

Escala temporal

Ambas variables se registran diariamente durante el año 2024. Para efectos de este análisis, se considera el periodo comprendido entre el 1 de enero de 2024 y el 31 de diciembre de 2024, lo cual permite caracterizar la variabilidad temporal y espacial del PM2.5 y la temperatura en el estado de Texas durante un ciclo anual completo.

Descripción

Se analiza la temperatura en distintas estaciones de Texas durante el día 24/04/2024. A continuación se realiza el análisis.

Code
Stations <- read.csv("temp_stations_NA.csv", check.names = FALSE)
Stations_sf <- st_as_sf(Stations,
                        coords = c("X", "Y"),
                        crs = 3083)

temp.data <- read.csv("tempdata.csv", check.names = FALSE)


Temp_map <- Stations_sf %>%
  left_join(temp.data, by = "AQSID") %>% 
  na.omit()

mapview(Temp_map, 
        zcol = "Temp", 
        legend = TRUE, 
        cex = 7, 
        col.regions = viridisLite::viridis, 
        popup = Temp_map$AQSID,
        layer.name = "°C")

Análisis de Estacionariedad

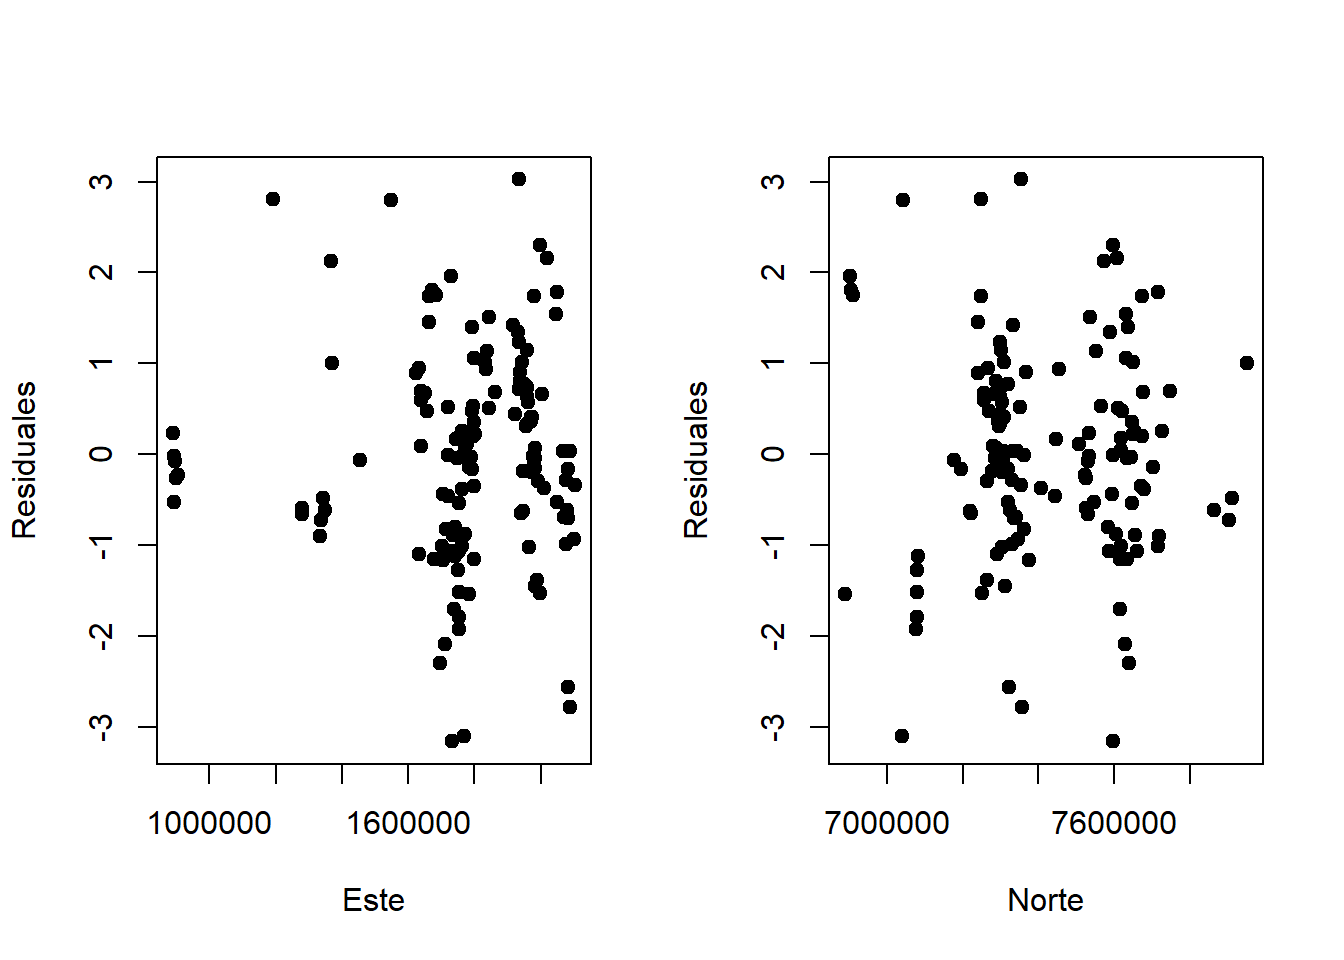
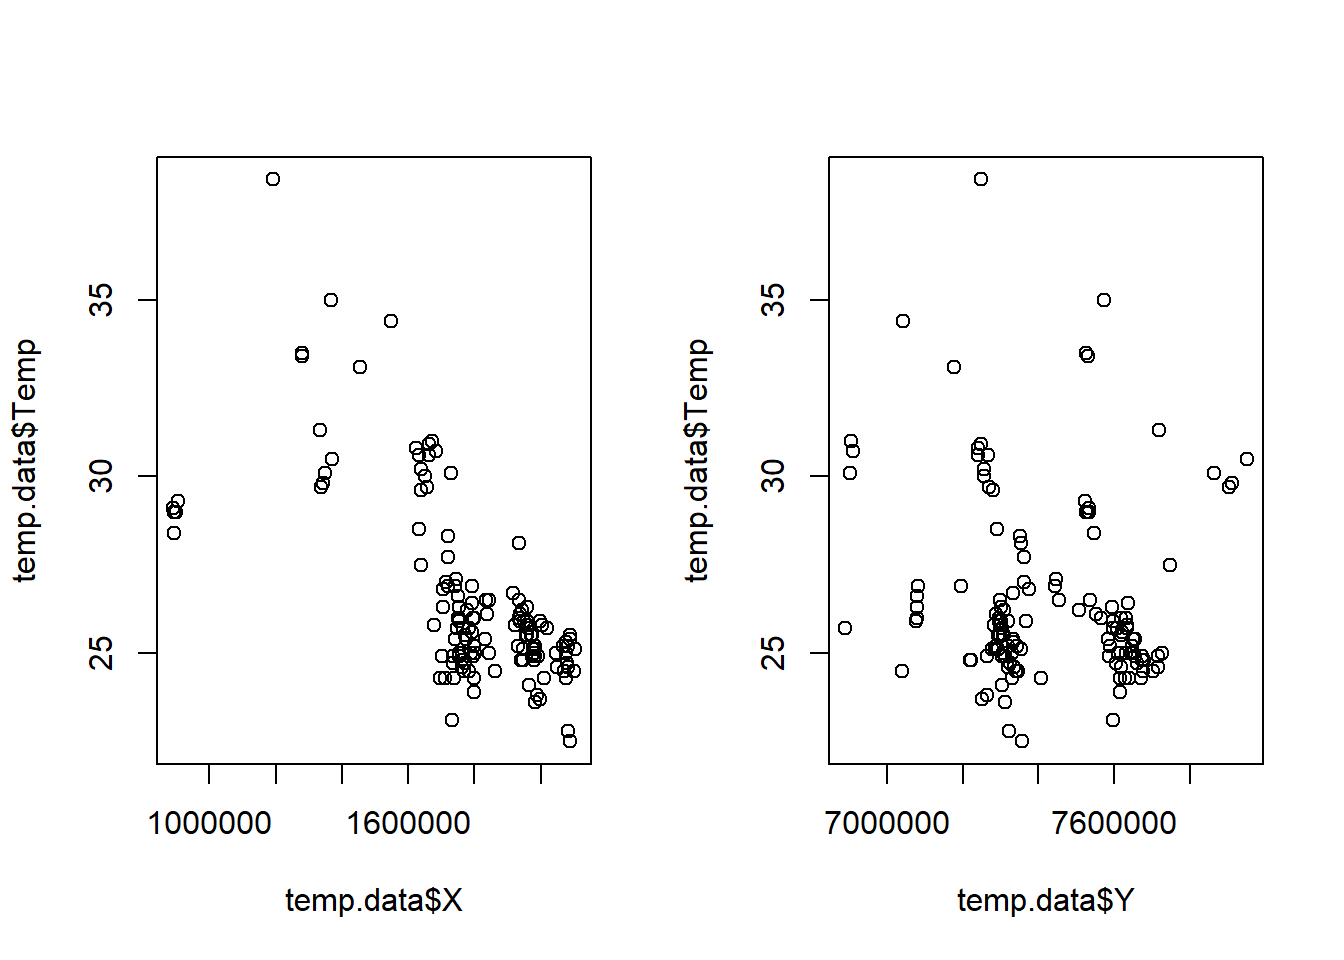
Primero, analizamos si se satisface la estacionariedad con respecto a la media. Para esto, nos apoyamos en los siguientes gráficos:

Como se puede ver, no hay estacionariedad. Por lo tanto, se ajusta un modelo de regresión, de forma que los residuales presenten media 0 y se comporte de forma constante.

El mejor modelo que se ajustó tiene la siguiente forma:

\[ \text{temp}_i = \beta_0 + \beta_1\cdot x + \beta_2 \cdot y + \beta_3 \cdot y^2 \]

Code
fit.temp <- lm(Temp ~ X + Y + I(X^2) + I(X^3) + I(Y^3), data = temp.data)
summary(fit.temp)

Call:
lm(formula = Temp ~ X + Y + I(X^2) + I(X^3) + I(Y^3), data = temp.data)

Residuals:
    Min      1Q  Median      3Q     Max 
-3.1534 -0.6908 -0.0129  0.6860  3.0235 

Coefficients:
              Estimate Std. Error t value Pr(>|t|)    
(Intercept) -2.879e+02  7.389e+01  -3.896 0.000153 ***
X            2.830e-04  2.317e-05  12.216  < 2e-16 ***
Y            4.024e-05  1.422e-05   2.831 0.005357 ** 
I(X^2)      -1.894e-10  1.549e-11 -12.227  < 2e-16 ***
I(X^3)       3.953e-17  3.326e-18  11.887  < 2e-16 ***
I(Y^3)      -2.718e-19  8.644e-20  -3.144 0.002053 ** 
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 1.172 on 134 degrees of freedom
Multiple R-squared:  0.8054,    Adjusted R-squared:  0.7981 
F-statistic: 110.9 on 5 and 134 DF,  p-value: < 2.2e-16

Como se puede ver, se tiene un \(R^2\) del casi 90%. También veamos el gráfico de los valores ajustados vs los residuales.

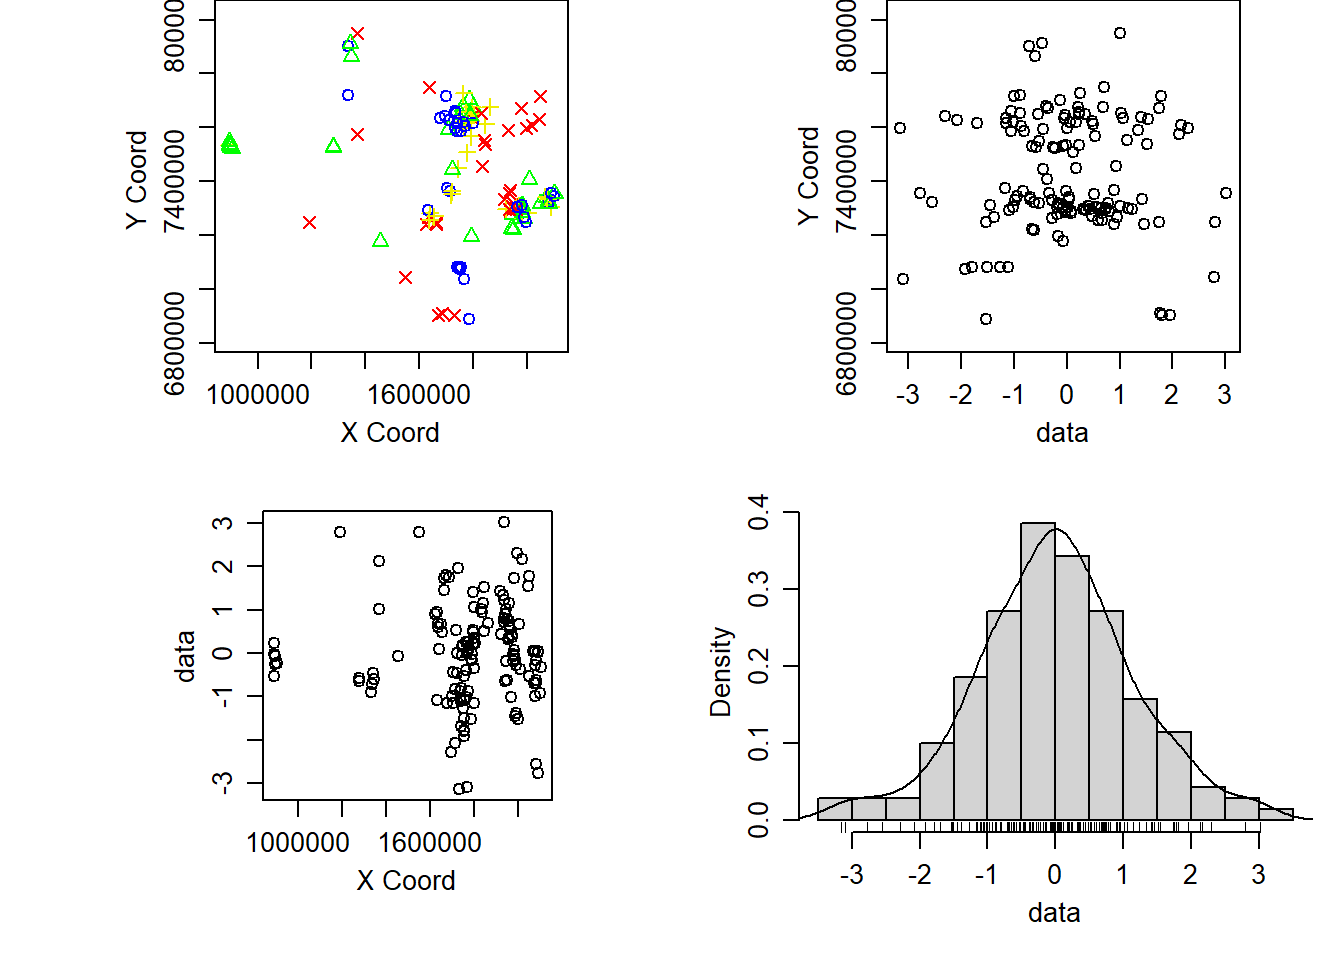
Obteniendo, de esta forma, los siguientes gráficos descriptivos:

Code
temp.data$Residuals <- resid(fit.temp)

temp.Data <- as.data.frame(temp.data)

tempg <- as.geodata(temp.data, 
                    coords.col = c("X", "Y"), 
                    data.col = "Residuals")
plot(tempg)

Semivariograma

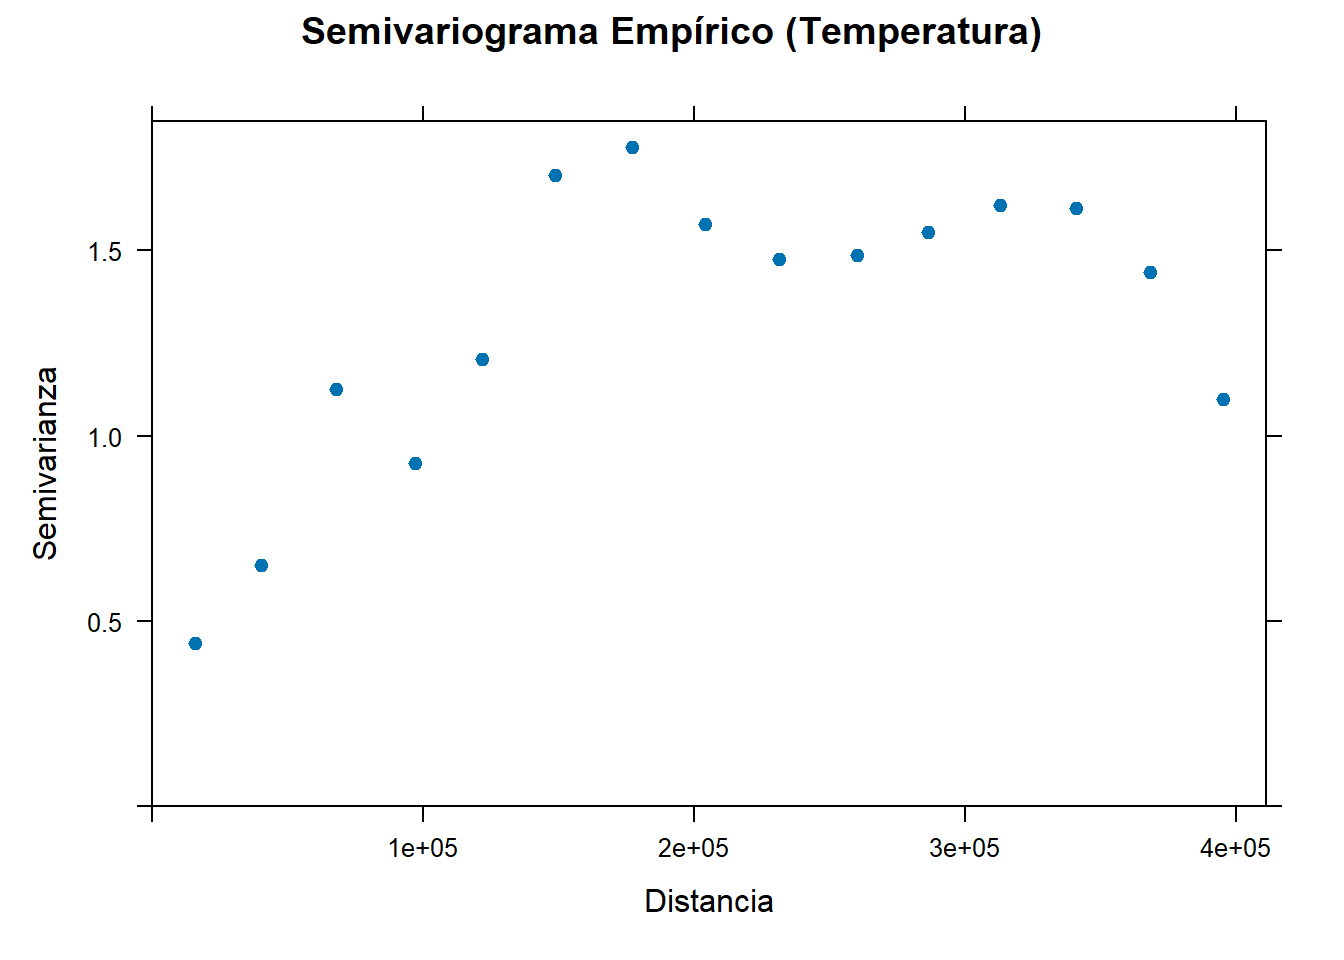
A continuación se presenta la estimación empírica del semivariograma:

Code
coordinates(temp.data) <- ~ X + Y

maxdist <- max(dist(coordinates(temp.data)))

cutoff <- 1/3*maxdist; width <- cutoff/15

vgm <- variogram(Temp ~ X + Y + I(X^2) + I(X^3) + I(Y^3), 
                 data = temp.data,
                 cutoff = cutoff, width = width)

vg <- variog(tempg, uvec = seq(vgm$dist[1], cutoff, by= width))
variog: computing omnidirectional variogram
Code
plot(vgm, ylab = "Semivarianza", xlab = "Distancia",
     pch = 19, main = "Semivariograma Empírico (Temperatura)")

De este semivariograma podemos ver que se tiene un nugget pequeño. Además, la estructura de dependencia espacial es evidente: la semivarianza aumenta con la distancia, lo que sugiere que las estaciones cercanas presentan temperaturas más similares entre sí que las estaciones más alejadas.

Estimación del Semivariograma Teórico

Como un ajuste inicial, se usa la función eyefit de geoR para poder obtener unos buenos valores iniciales para los modelos que más se ajustan al semivariograma empírico. Se definen las funciones que se usarán para esto:

Code
gamma_sph <- function(h, c0, cs, a){
  ifelse(h == 0,
         0,
         ifelse(h <= a,
                c0 + cs * ( 1.5*(h/a) - 0.5*(h/a)^3 ),
                c0 + cs))
}


gamma_exp <- function(h, c0, cs, a){
  ifelse(h == 0,
         0,
         c0 + cs * (1 - exp(-(h/a))))
}


gamma_gaus <- function(h, c0, cs, a){
  ifelse(h == 0,
         0,
         c0 + cs*(1 - exp(-(h/a)^2)))
}


gamma_mat <- function(h, c0, cs, a, kappa = 1.35){
  ifelse(h == 0,
         0,
         c0 + cs * (1 - ((h / a)^kappa * besselK(h / a, nu = kappa)) /
                      (2^(kappa - 1) * gamma(kappa)))
  )
}


gamma_wave <- function(h, c0, cs, a){
  ifelse(h == 0,
         0,  
         c0 + cs * (1 - (sin(h/a) / (h/a))))
}


MSE <- function(fitted, observed){
  
  mean((fitted - observed)^2)
  
}

data <- data.frame(h = vg$u,
                   gamma_hat = vg$v,
                   n = vg$n)

Y con los valores iniciales

# CUBIC
init_cub <- c(c0 = 0.28, cs = 1.10, a = 210000)

# EXPONENTIAL
init_exp <- c(c0 = 0.28, cs = 1.18, a = 81081.1)

# GAUSSIAN
init_gau <- c(c0 = 0.28, cs = 1.26, a = 97297.3)

# MATERN 
init_mat <- c(c0 = 0.28, cs = 1.34, a = 64864.86, kappa = 1.35)

# SPHERICAL
init_sph <- c(c0 = 0.28, cs = 1.20, a = 162162.16)

# WAVE
init_wav <- c(c0 = 0.28, cs = 1.19, a = 32214)

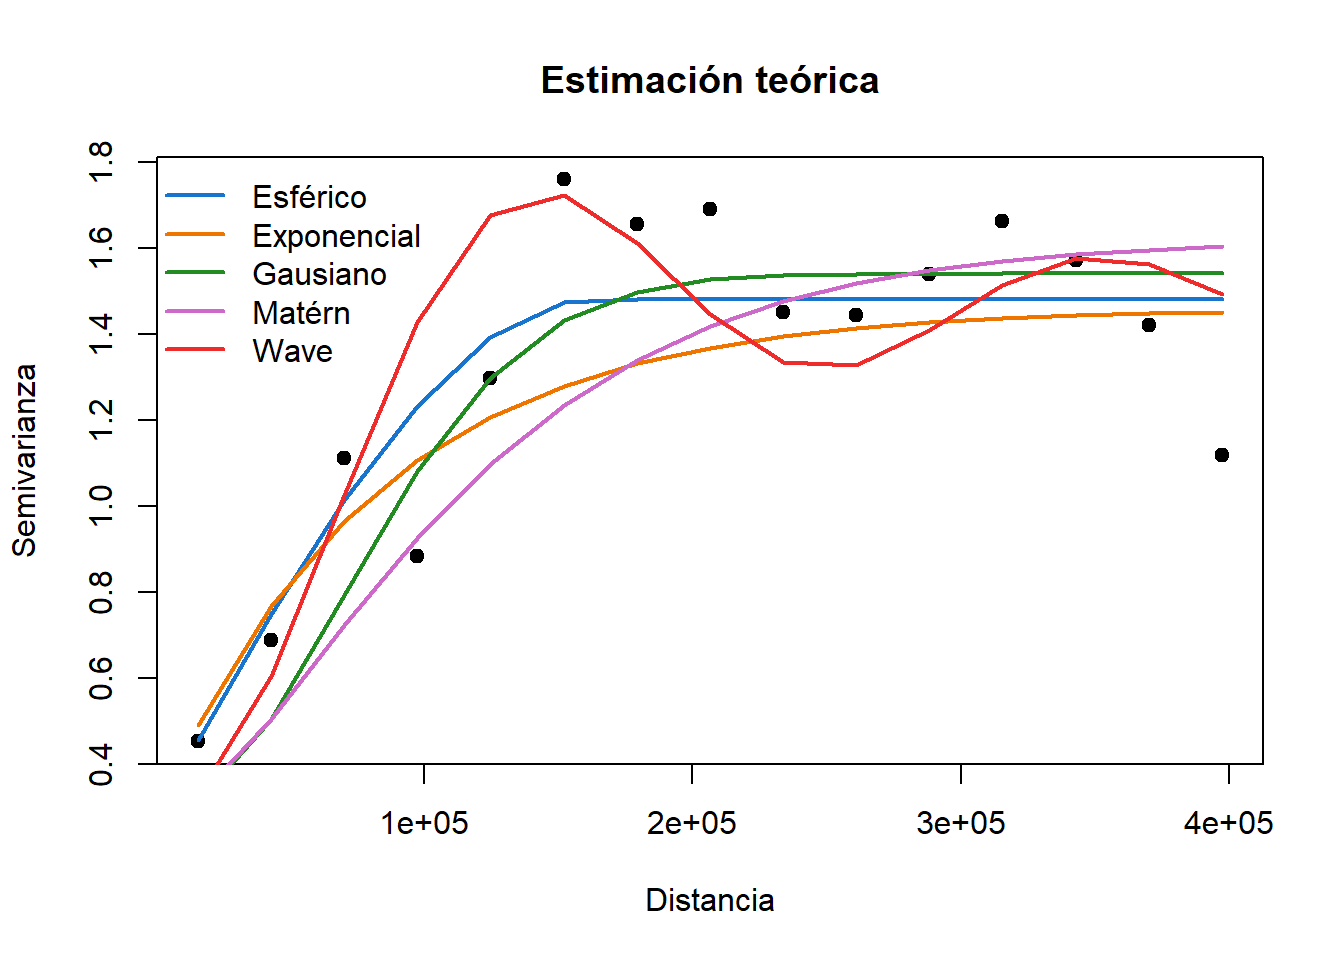
Se grafican estos ajustes “a ojo” iniciales.

Code
fit.sph_1 <- gamma_sph(h = data$h, c0 = init_sph[1], cs = init_sph[2], a = init_sph[3])
mse_1 <- mean((fit.sph_1 - data$gamma_hat)^2)

fit.exp_1 <- gamma_exp(h = data$h, c0 = init_exp[1], cs = init_exp[2], a = init_exp[3])
mse_2 <- mean((fit.exp_1 - data$gamma_hat)^2)

fit.gaus_1 <- gamma_gaus(h = data$h, c0 = init_gau[1], cs = init_gau[2], a = init_gau[3])
mse_3 <- mean((fit.gaus_1 - data$gamma_hat)^2)

fit.mat_1 <- gamma_mat(h = data$h, c0 = init_mat[1], cs = init_mat[2], a = init_mat[3], kappa = init_mat[4])
mse_4 <- mean((fit.mat_1 - data$gamma_hat)^2)

fit.wave_1 <- gamma_wave(h = data$h, c0 = init_wav[1], cs = init_wav[2], a = init_wav[3])
mse_5 <- mean((fit.wave_1 - data$gamma_hat)^2)


colors <- c(
  "dodgerblue3",   # esférico
  "darkorange2",   # exponencial
  "forestgreen",   # gaussiano
  "orchid3",       # matern
  "firebrick2"     # wave
)


plot(x = data$h, y = data$gamma_hat, pch = 19,
     xlab = "Distancia",
     ylab = "Semivarianza",
     main = "Estimación teórica")

lines(data$h, fit.sph_1,  col = colors[1], lwd = 2)
lines(data$h, fit.exp_1,  col = colors[2], lwd = 2)
lines(data$h, fit.gaus_1, col = colors[3], lwd = 2)
lines(data$h, fit.mat_1,  col = colors[4], lwd = 2)
lines(data$h, fit.wave_1, col = colors[5], lwd = 2)

legend("topleft",
       legend = c("Esférico", "Exponencial", "Gausiano", "Matérn", "Wave"),
       col    = colors,
       lwd    = 2,
       pch    = NA,
       bty    = "n")

Regresión No Lineal

Primero, realizamos un ajuste mediante las funciones nls (base) y nlsLM del paquete minpack.lm. Para cada modelo se tuvieron en cuenta los siguientes pesos:

\[ 1, \qquad n, \qquad \frac{n}{h^2} \]

Code
nls.sph1 <- nls(gamma_hat ~ gamma_sph(h, c0, cs, a),
                data = data,
                start = as.list(init_sph))

nls.sph2 <- nls(gamma_hat ~ gamma_sph(h, c0, cs, a),
                data = data,
                start = as.list(init_sph), 
                weights = n)


nls.sph3 <- nlsLM(gamma_hat ~ gamma_sph(h, c0, cs, a),
                  data = data, 
                  start = as.list(init_sph),
                  weights = (n/h^2),
                  control = nls.lm.control(maxiter=1000, ftol=1e-10, ptol=1e-10))


nls.exp1 <- nls(gamma_hat ~ gamma_exp(h, c0, cs, a),
                data = data,
                start = as.list(init_exp), 
                algorithm = "port",
                lower = c(0, 0, 0))

nls.exp2 <- nls(gamma_hat ~ gamma_exp(h, c0, cs, a),
                data = data,
                start = as.list(init_exp), 
                algorithm = "port",
                lower = c(0, 0, 0), 
                weights = n)

nls.exp3 <- nlsLM(gamma_hat ~ gamma_exp(h, c0, cs, a),
                  data = data, 
                  start = as.list(init_exp),
                  weights = (n/h^2),
                  control = nls.lm.control(maxiter=1000, ftol=1e-10, ptol=1e-10))


nls.gaus1 <- nls(gamma_hat ~ gamma_gaus(h, c0, cs, a),
                 data = data,
                 start = as.list(init_gau))

ctrl <- nls.control(maxiter = 1000, tol = 1e-10, minFactor = 1/1024)
nls.gaus2 <- nlsLM(gamma_hat ~ gamma_gaus(h, c0, cs, a),
                  data = data,
                  start = as.list(init_gau),
                  weights = n,
                  control = ctrl)

nls.gaus3 <- nlsLM(gamma_hat ~ gamma_gaus(h, c0, cs, a),
                   data = data, 
                   start = as.list(init_gau),
                   weights = (n/h^2),
                   control = nls.lm.control(maxiter=1000, ftol=1e-10, ptol=1e-10))


nls.mat1 <- nls(gamma_hat ~ gamma_mat(h, c0, cs, a, kappa = 1.35),
                data = data,
                start = as.list(init_mat[-4]))

nls.mat2 <- nls(gamma_hat ~ gamma_mat(h, c0, cs, a, kappa = 1.35),
                data = data,
                start = as.list(init_mat[-4]), 
                weights = n)

nls.mat3 <- nlsLM(gamma_hat ~ gamma_mat(h, c0, cs, a, kappa = 1.35),
                  data = data, 
                  start = as.list(init_mat[-4]),
                  weights = (n/h^2),
                  control = nls.lm.control(maxiter=1000, ftol=1e-10, ptol=1e-10))


nls.wave1 <- nls(gamma_hat ~ gamma_wave(h, c0, cs, a),
                 data = data,
                 start = as.list(init_wav))

nls.wave2 <- nls(gamma_hat ~ gamma_wave(h, c0, cs, a),
                 data = data,
                 start = as.list(init_wav), 
                 weights = n)

nls.wave3 <- nls(gamma_hat ~ gamma_wave(h, c0, cs, a),
                 data = data,
                 start = as.list(init_wav), 
                 algorithm = "port",
                 lower = c(0, 0, 0), 
                 weights = (n/h^2))
De esta forma, se obtienen los siguientes resultados:

MSE para cada modelo y peso
Modelo MSE Peso
Esférico 0.0300 \(1\)
Esférico 0.0309 \(n\)
Esférico 0.0304 \(\frac{n}{h^2}\)
Exponencial 0.0372 \(1\)
Exponencial 0.0385 \(n\)
Exponencial 0.0434 \(\frac{n}{h^2}\)
Gaussiano 0.0320 \(1\)
Gaussiano 0.0330 \(n\)
Gaussiano 0.0329 \(\frac{n}{h^2}\)
Mátern 0.0346 \(1\)
Mátern 0.0358 \(n\)
Mátern 0.0359 \(\frac{n}{h^2}\)
Wave 0.0281 \(1\)
Wave 0.0481 \(n\)
Wave 0.0368 \(\frac{n}{h^2}\)

El mejor por modelo se presenta a continuación:

Mejor combinación modelo–peso
Modelo MSE Peso
Esférico 0.0300 \(1\)
Exponencial 0.0372 \(1\)
Gaussiano 0.0320 \(1\)
Mátern 0.0346 \(1\)
Wave 0.0281 \(1\)

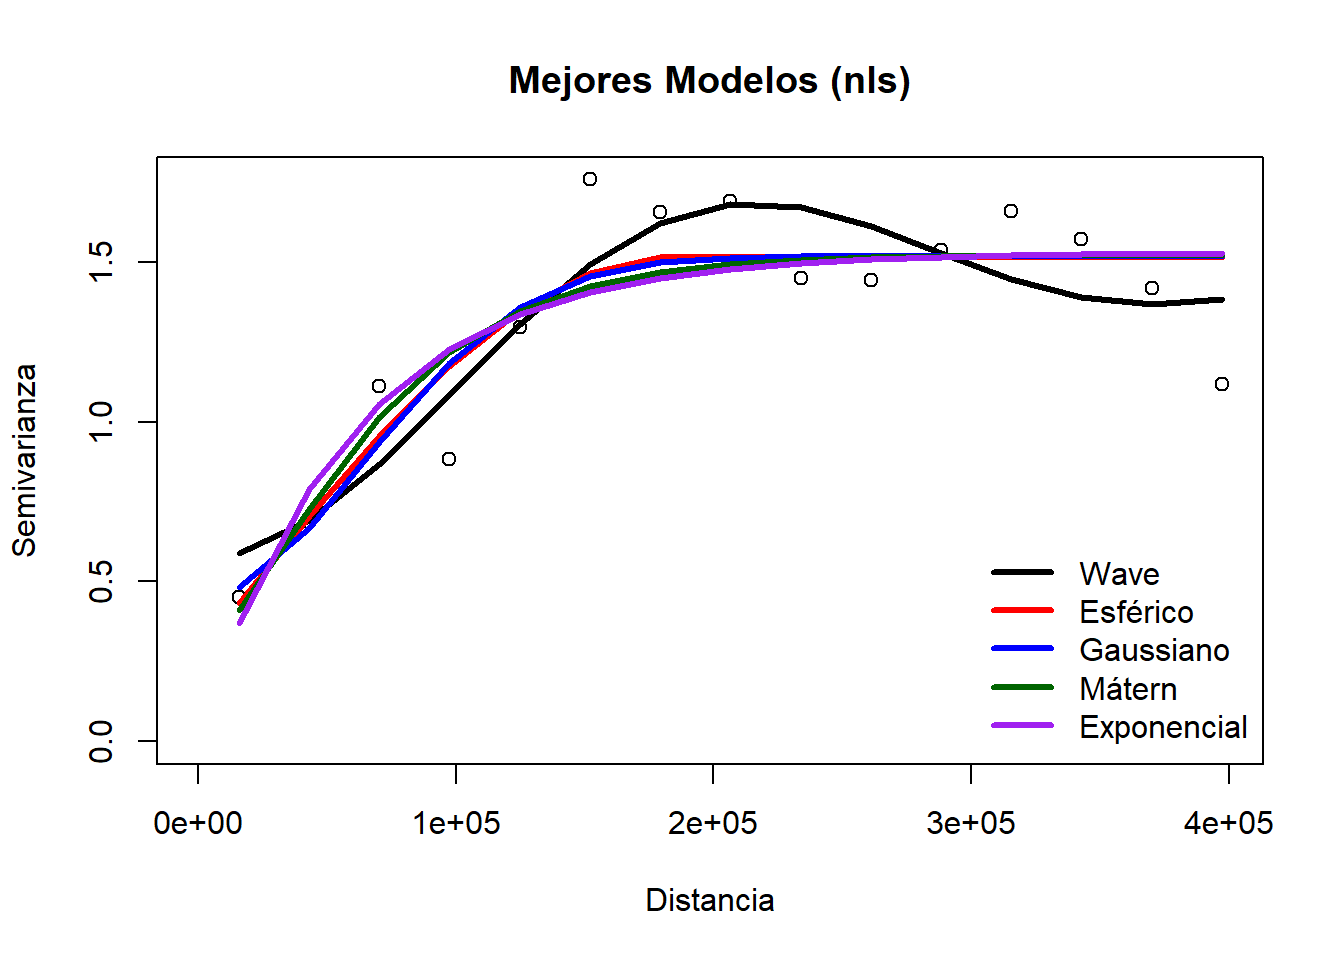
Por este método, el mejor ajuste que se obtuvo fue con el modelo Wave con parámetros al obtener un menor MSE.

Veamos gráficamente como se ven estos modelos:

Cressie

Ahora se considera un método en el cual la matriz de ponderaciones cambia en cada iteración. Esto se desarrollará mediante las siguientes funciones:

Code
Q_cressie <- function(par, data, gamma_fun, kappa = NULL, eps = 1e-12){
  
  g <- if (is.null(kappa)) {
    gamma_fun(h = data$h, c0 = par["c0"], cs = par["cs"], a = par["a"])
    
  } else {
    
    gamma_fun(h = data$h, c0 = par["c0"], cs = par["cs"], a = par["a"], kappa = kappa)
    
  }
  
  g2 <- pmax(g^2, eps)         
  
  sum( data$n * (data$gamma_hat - g)^2 / (2 * g2), na.rm = TRUE )
}


fit_cressie <- function(gamma_fun, start, data,
                        lower = c(c0=0, cs=0, a=.Machine$double.eps),
                        upper = c(c0=Inf, cs=Inf, a=Inf),
                        kappa = NULL){
  
  par0 <- start[c("c0","cs","a")]    
  
  opt <- optim(par = par0, fn = Q_cressie, method = "L-BFGS-B",
               lower = lower, upper = upper,
               data = data, gamma_fun = gamma_fun, kappa = kappa)
  
  
  p  <- opt$par
  
  g  <- if (is.null(kappa)) {
    gamma_fun(data$h, p["c0"], p["cs"], p["a"])
  } else {
    gamma_fun(data$h, p["c0"], p["cs"], p["a"], kappa)
  }    
  
  mse <- MSE(g, data$gamma_hat)
  
  list(par = p, converged = (opt$convergence==0),
       fitted = g, MSE = mse, kappa = kappa)
}

De esta forma, se realiza el ajuste para cada modelo.

Code
cress.sph <- fit_cressie(gamma_sph, start = init_sph, data = data)


cress.exp <- fit_cressie(gamma_exp, start = init_exp, data = data)


cress.gaus <- fit_cressie(gamma_gaus, start = init_gau, data = data)


cress.mat <- fit_cressie(gamma_mat, start = init_mat, data = data, kappa = 1.35)


cress.wave <- fit_cressie(gamma_wave, start = init_wav, data = data)

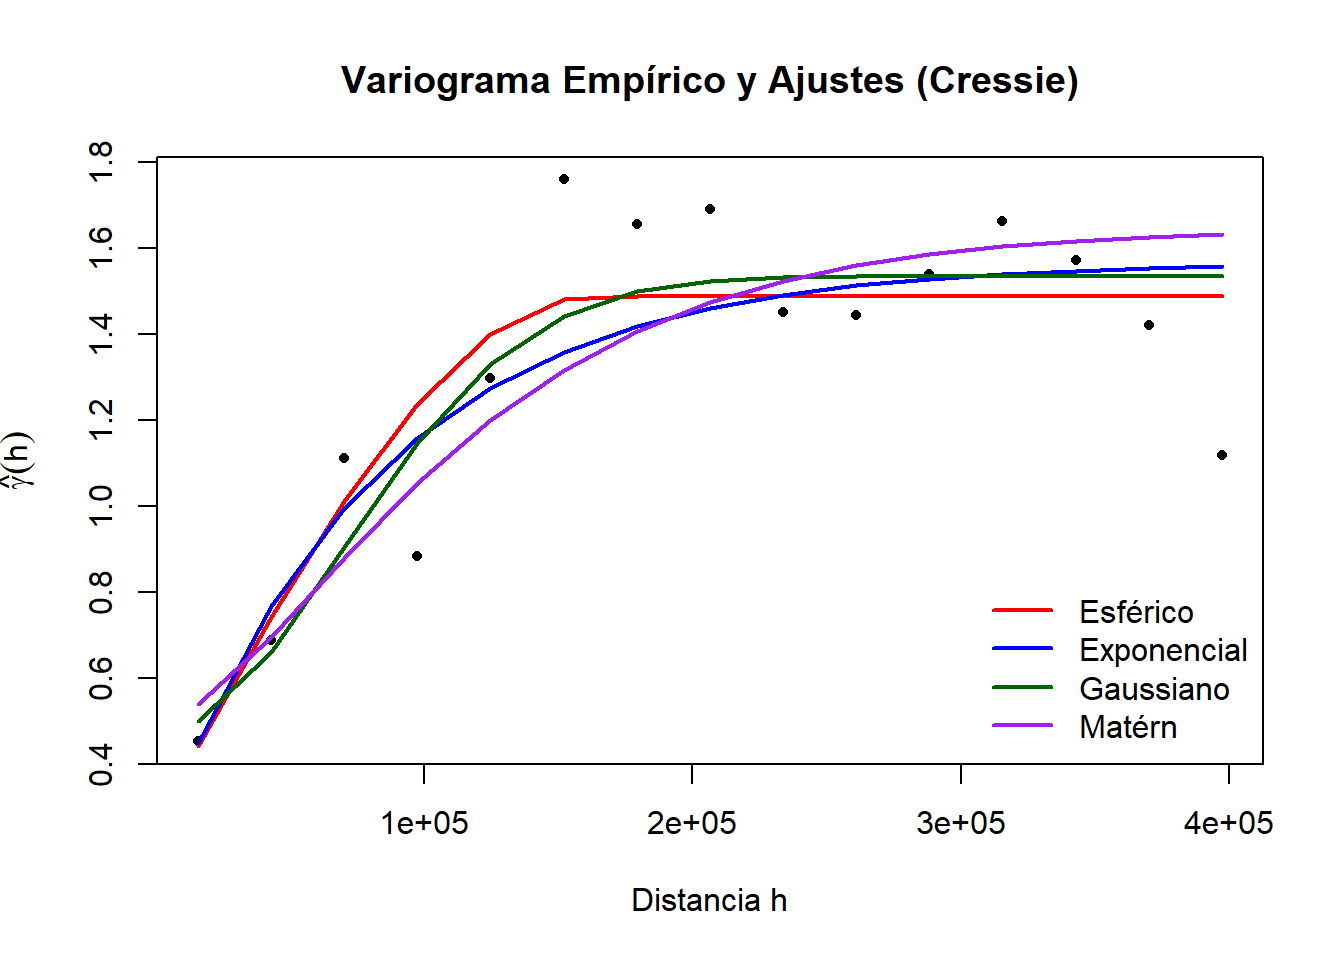
Obteniendo los siguientes resultados:

ord <- order(data$h)

plot(data$h, data$gamma_hat,
     pch = 16, cex = 0.7,
     xlab = "Distancia h",
     ylab = expression(hat(gamma)(h)),
     main = "Variograma Empírico y Ajustes (Cressie)")

lines(data$h[ord], cress.sph$fitted[ord],  col = "red",       lwd = 2)
lines(data$h[ord], cress.exp$fitted[ord],  col = "blue",      lwd = 2)
lines(data$h[ord], cress.gaus$fitted[ord], col = "darkgreen", lwd = 2)
lines(data$h[ord], cress.mat$fitted[ord],  col = "purple",    lwd = 2)

legend("bottomright",
       legend = c("Esférico",
                  "Exponencial",
                  "Gaussiano",
                  "Matérn"),
       col    = c("red", "blue", "darkgreen", "purple"),
       lty    = 1.5,
       lwd    = 2,
       bty    = "n")

MSE para ajustes Cressie
Modelo MSE
sph 0.0318
exp 0.0399
gaus 0.0325
mat 0.0492
wave 0.0455

De esta forma, es posible ver que el menor error cuadrático medio lo tiene el modelo esférico. De todas formas, no es menor que el obtenido por regresión no lineal.

Máxima Verosimilitud

Al considerar este método es necesario expresar las matrices de covarianza en función de los parámetros que deseamos estimar. Esto es:

Entonces, se encuentran las funciones de covarianza para cada modelo:

Code
cov.gaus <- function(h, c0, cs, a){
  ifelse(h == 0,
         c0 + cs,
         cs * exp(-(h/a)^2))
}

cov.exp <- function(h, c0, cs, a){
  ifelse(h == 0,
         c0 + cs,
         cs * exp(-h/a))
}

cov.sph <- function(h, c0, cs, a){
  ifelse(h == 0,
         c0 + cs,
         ifelse(h > 0 & h < a,
                cs * (1 - (3/2)*(h/a) + (1/2)*(h/a)^3),
                0))
}

cov.mat <- function(h, c0, cs, a, kappa = 1.35){
  ifelse(h == 0,
         c0 + cs,
         cs * (1 - (1 - ((h / a)^kappa * besselK(h / a, nu = kappa)) /
                 (2^(kappa - 1) * gamma(kappa)))))
}

cov.wave <- function(h, c0, cs, a){
  ifelse(h == 0,
         c0 + cs,
         cs * (sin(h/a)/(h/a)))
}

Y además, la función de log-verosimilitud explícita para poder realizar la optimización con la ayuda de optim.

Code
loglik.model <- function(par, Z, coords, cov.model) {
  c0 <- par[1]  
  cs <- par[2]   
  a  <- par[3]   
  
  
  h <- as.matrix(dist(coords))
  
  
  Sigma <- cov.model(h, c0, cs, a)
  
  
  n <- length(Z)
  L <- try(chol(Sigma), silent = TRUE)
  if (inherits(L, "try-error")) return(1e6)
  
  
  SinvZ <- backsolve(L, forwardsolve(t(L), Z))
  
  logdet <- 2 * sum(log(diag(L)))
  nll <- 0.5 * (n * log(2*pi) + logdet + sum(Z * SinvZ))
  
  return(nll)  
}

De esta forma, se realiza el ajuste para los modelos:

Code
mv.sph <- optim(
  par = init_sph,
  fn = loglik.model,
  Z = temp.data$Residuals,
  coords = coordinates(temp.data),
  cov.model = cov.sph,
  method = "L-BFGS-B",
  lower = c(0, 0, 0)
)

mv.sph <- within(mv.sph, {
  MSE        <- with(as.list(par), MSE(gamma_sph(data$h, c0, cs, a), data$gamma_hat))
  gamma_pred <- with(as.list(par), gamma_sph(data$h, c0, cs, a))
})


mv.exp <- optim(
  par = init_exp,
  fn = loglik.model,
  Z = temp.data$Residuals,
  coords = coordinates(temp.data),
  cov.model = cov.exp,
  method = "L-BFGS-B",
  lower = c(0, 0, 0)
)

mv.exp <- within(mv.exp, {
  MSE        <- with(as.list(par), MSE(gamma_exp(data$h, c0, cs, a), data$gamma_hat))
  gamma_pred <- with(as.list(par), gamma_exp(data$h, c0, cs, a))
})


mv.gaus <- optim(
  par = init_gau,
  fn = loglik.model,
  Z = temp.data$Residuals,
  coords = coordinates(temp.data),
  cov.model = cov.gaus,
  method = "L-BFGS-B",
  lower = c(0, 0, 0)
)

mv.gaus <- within(mv.gaus, {
  MSE        <- with(as.list(par), MSE(gamma_gaus(data$h, c0, cs, a), data$gamma_hat))
  gamma_pred <- with(as.list(par), gamma_gaus(data$h, c0, cs, a))
})


mv.mat <- optim(
  par = init_mat,
  fn = loglik.model,
  Z = temp.data$Residuals,
  coords = coordinates(temp.data),
  cov.model = cov.mat,
  method = "L-BFGS-B",
  lower = c(0, 0, 0)
)

mv.mat <- within(mv.mat, {
  MSE        <- with(as.list(par), MSE(gamma_mat(data$h, c0, cs, a, kappa = 1.35), 
                                       data$gamma_hat))
  gamma_pred <- with(as.list(par), gamma_mat(data$h, c0, cs, a, kappa = 1.35))
})


mv.wave <- optim(
  par = init_wav,
  fn = loglik.model,
  Z = temp.data$Residuals,
  coords = coordinates(temp.data),
  cov.model = cov.wave,
  method = "L-BFGS-B",
  lower = c(0, 0, 0),
  upper = c(Inf, Inf, Inf)
)

mv.wave <- within(mv.wave, {
  MSE        <- with(as.list(par), MSE(gamma_wave(data$h, c0, cs, a), data$gamma_hat))
  gamma_pred <- with(as.list(par), gamma_wave(data$h, c0, cs, a))
})

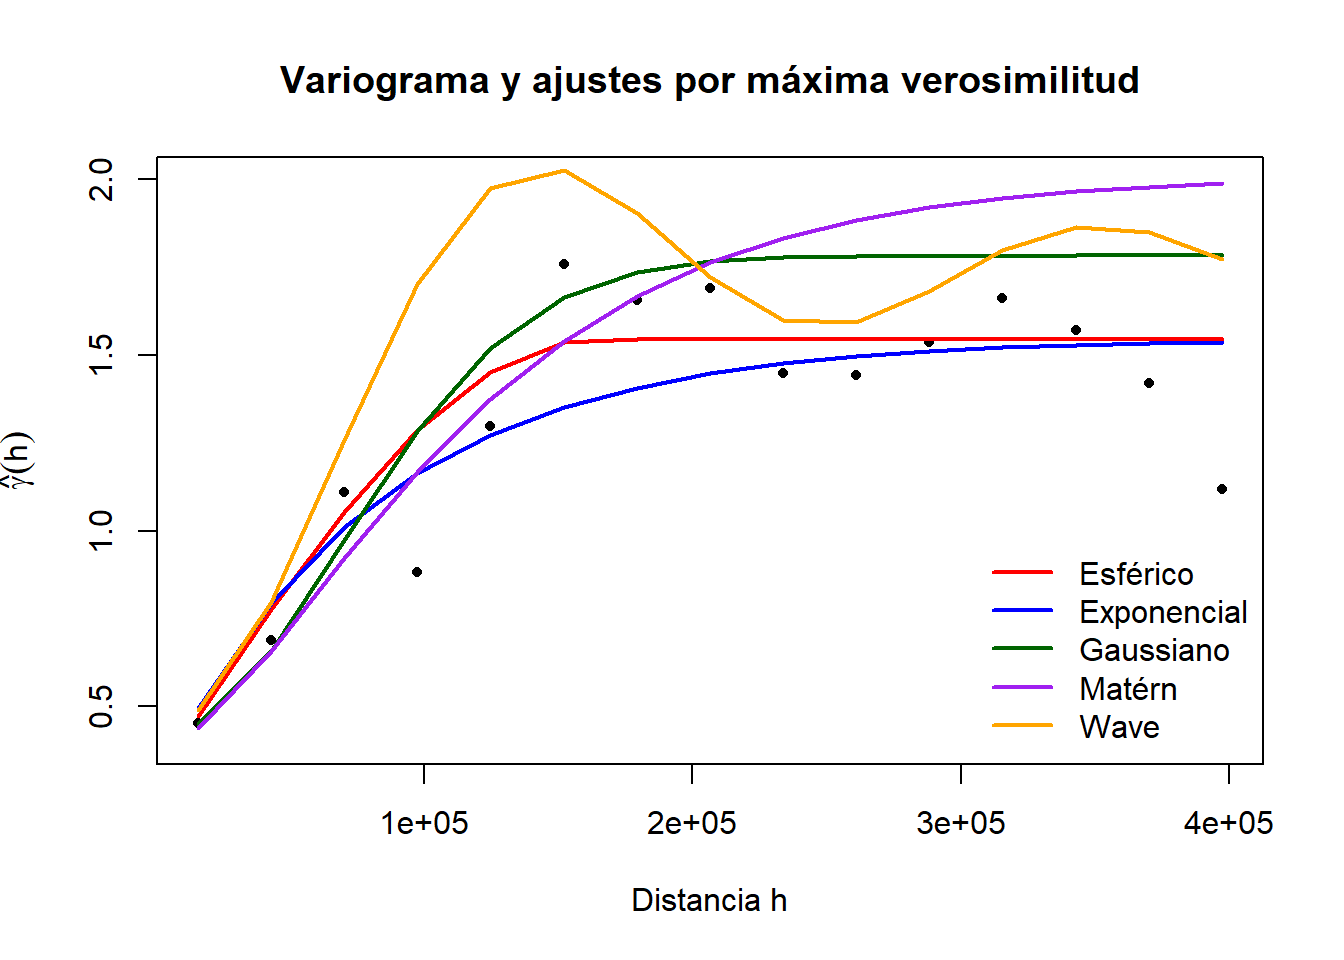
Obteniendo los siguientes resultados:

MSE para ajustes MV
Modelo MSE
Esférico 0.0340
Exponencial 0.0403
Gausiano 0.0780
Matern 0.1318
Wave 0.1394

Vemos que el mejor modelo en este caso es el esférico. De igual forma que se había comentado con Cressie, este modelo sigue teniendo mayor MSE que el obtenido por regresión no lineal.

MCO y MCP

Primero, se realiza la construcción de las funciones que se van a usar para la estimación por mínimos cuadrados.

Code
LS.model <- function(par, data, gamma.model, w = c("1", "n", "n/h2")){
  c0 <- par[1]  
  cs <- par[2]   
  a  <- par[3] 
  
  h <- data$h
  gamma_hat  <- data$gamma
  n_pairs <- data$n
  
  
  gamma_theo <- gamma.model(h, c0, cs, a)
  
  diff <- gamma_hat - gamma_theo
  
  
  w <- match.arg(w)
  w <- switch(w,
              "1"      = rep(1, length(h)),
              "n"         = n_pairs,
              "n/h2" = n_pairs / (h^2))
  
  Q <- sum(w * diff^2, na.rm = TRUE)
  
  return(Q)
}

MSE_fit <- function(par, gamma.model){
  mean((data$gamma - gamma.model(data$h, par[1], par[2], par[3]))^2)
}
Code
mc0.sph <- optim(
  par = init_sph,
  fn = LS.model,
  data = data,
  gamma.model = gamma_sph,
  w = "1",
  method = "L-BFGS-B",
  lower = c(0, 0, 0))

mc1.sph <- optim(
  par = init_sph,
  fn = LS.model,
  data = data,
  gamma.model = gamma_sph,
  w = "n",
  method = "L-BFGS-B",
  lower = c(0, 0, 0))


mc2.sph <- optim(
  par = init_sph,
  fn = LS.model,
  data = data,
  gamma.model = gamma_sph,
  w = "n/h2",
  method = "L-BFGS-B",
  lower = c(0, 0, 0))
Peso MSE
\(1\) 0.0300
\(n\) 0.0309
\(\frac{n}{h^2}\) 0.0322
Code
mc0.exp <- optim(
  par = init_exp,
  fn = LS.model,
  data = data,
  gamma.model = gamma_exp,
  w = "1",
  method = "L-BFGS-B",
  lower = c(0, 0, 0))

mc1.exp <- optim(
  par = init_exp,
  fn = LS.model,
  data = data,
  gamma.model = gamma_exp,
  w = "n",
  method = "L-BFGS-B",
  lower = c(0, 0, 0))


mc2.exp <- optim(
  par = init_exp,
  fn = LS.model,
  data = data,
  gamma.model = gamma_exp,
  w = "n/h2",
  method = "L-BFGS-B",
  lower = c(0, 0, 0))
Peso MSE
\(1\) 0.0372
\(n\) 0.0385
\(\frac{n}{h^2}\) 0.0481
Code
mc0.gau <- optim(
  par = init_gau,
  fn = LS.model,
  data = data,
  gamma.model = gamma_gaus,
  w = "1",
  method = "L-BFGS-B",
  lower = c(0, 0, 0))

mc1.gau <- optim(
  par = init_gau,
  fn = LS.model,
  data = data,
  gamma.model = gamma_gaus,
  w = "n",
  method = "L-BFGS-B",
  lower = c(0, 0, 0))


mc2.gau <- optim(
  par = init_gau,
  fn = LS.model,
  data = data,
  gamma.model = gamma_gaus,
  w = "n/h2",
  method = "L-BFGS-B",
  lower = c(0, 0, 0))
Peso MSE
\(1\) 0.0320
\(n\) 0.0330
\(\frac{n}{h^2}\) 0.0384
Code
mc0.mat <- optim(
  par = init_mat,
  fn = LS.model,
  data = data,
  gamma.model = gamma_mat,
  w = "1",
  method = "L-BFGS-B",
  lower = c(0, 0, 0))

mc1.mat <- optim(
  par = init_mat,
  fn = LS.model,
  data = data,
  gamma.model = gamma_mat,
  w = "n",
  method = "L-BFGS-B",
  lower = c(0, 0, 0))


mc2.mat <- optim(
  par = init_mat,
  fn = LS.model,
  data = data,
  gamma.model = gamma_mat,
  w = "n/h2",
  method = "L-BFGS-B",
  lower = c(0, 0, 0))
Peso MSE
\(1\) 0.0346
\(n\) 0.0358
\(\frac{n}{h^2}\) 0.0651
Code
mc0.wav <- optim(
  par = init_wav,
  fn = LS.model,
  data = data,
  gamma.model = gamma_wave,
  w = "1",
  method = "L-BFGS-B",
  lower = c(0, 0, 0))

mc1.wav <- optim(
  par = init_wav,
  fn = LS.model,
  data = data,
  gamma.model = gamma_wave,
  w = "n",
  method = "L-BFGS-B",
  lower = c(0, 0, 0))


mc2.wav <- optim(
  par = init_wav,
  fn = LS.model,
  data = data,
  gamma.model = gamma_wave,
  w = "n/h2",
  method = "L-BFGS-B",
  lower = c(0, 0, 0))
Code
mc0.sph <- optim(
  par = init_sph,
  fn = loglik.model,
  Z = temp.data$Residuals,
  coords = coordinates(temp.data),
  cov.model = cov.sph,
  method = "L-BFGS-B",
  lower = c(0, 0, 0)
)

mv.sph <- within(mv.sph, {
  MSE        <- with(as.list(par), MSE(gamma_sph(data$h, c0, cs, a), data$gamma_hat))
  gamma_pred <- with(as.list(par), gamma_sph(data$h, c0, cs, a))
})


mv.exp <- optim(
  par = init_exp,
  fn = loglik.model,
  Z = temp.data$Residuals,
  coords = coordinates(temp.data),
  cov.model = cov.exp,
  method = "L-BFGS-B",
  lower = c(0, 0, 0)
)

mv.exp <- within(mv.exp, {
  MSE        <- with(as.list(par), MSE(gamma_exp(data$h, c0, cs, a), data$gamma_hat))
  gamma_pred <- with(as.list(par), gamma_exp(data$h, c0, cs, a))
})


mv.gaus <- optim(
  par = init_gau,
  fn = loglik.model,
  Z = temp.data$Residuals,
  coords = coordinates(temp.data),
  cov.model = cov.gaus,
  method = "L-BFGS-B",
  lower = c(0, 0, 0)
)

mv.gaus <- within(mv.gaus, {
  MSE        <- with(as.list(par), MSE(gamma_gaus(data$h, c0, cs, a), data$gamma_hat))
  gamma_pred <- with(as.list(par), gamma_gaus(data$h, c0, cs, a))
})


mv.mat <- optim(
  par = init_mat,
  fn = loglik.model,
  Z = temp.data$Residuals,
  coords = coordinates(temp.data),
  cov.model = cov.mat,
  method = "L-BFGS-B",
  lower = c(0, 0, 0)
)

mv.mat <- within(mv.mat, {
  MSE        <- with(as.list(par), MSE(gamma_mat(data$h, c0, cs, a, kappa = 1.35), 
                                       data$gamma_hat))
  gamma_pred <- with(as.list(par), gamma_mat(data$h, c0, cs, a, kappa = 1.35))
})


mv.wave <- optim(
  par = init_wav,
  fn = loglik.model,
  Z = temp.data$Residuals,
  coords = coordinates(temp.data),
  cov.model = cov.wave,
  method = "L-BFGS-B",
  lower = c(0, 0, 0),
  upper = c(Inf, Inf, Inf)
)

mv.wave <- within(mv.wave, {
  MSE        <- with(as.list(par), MSE(gamma_wave(data$h, c0, cs, a), data$gamma_hat))
  gamma_pred <- with(as.list(par), gamma_wave(data$h, c0, cs, a))
})

Kriging

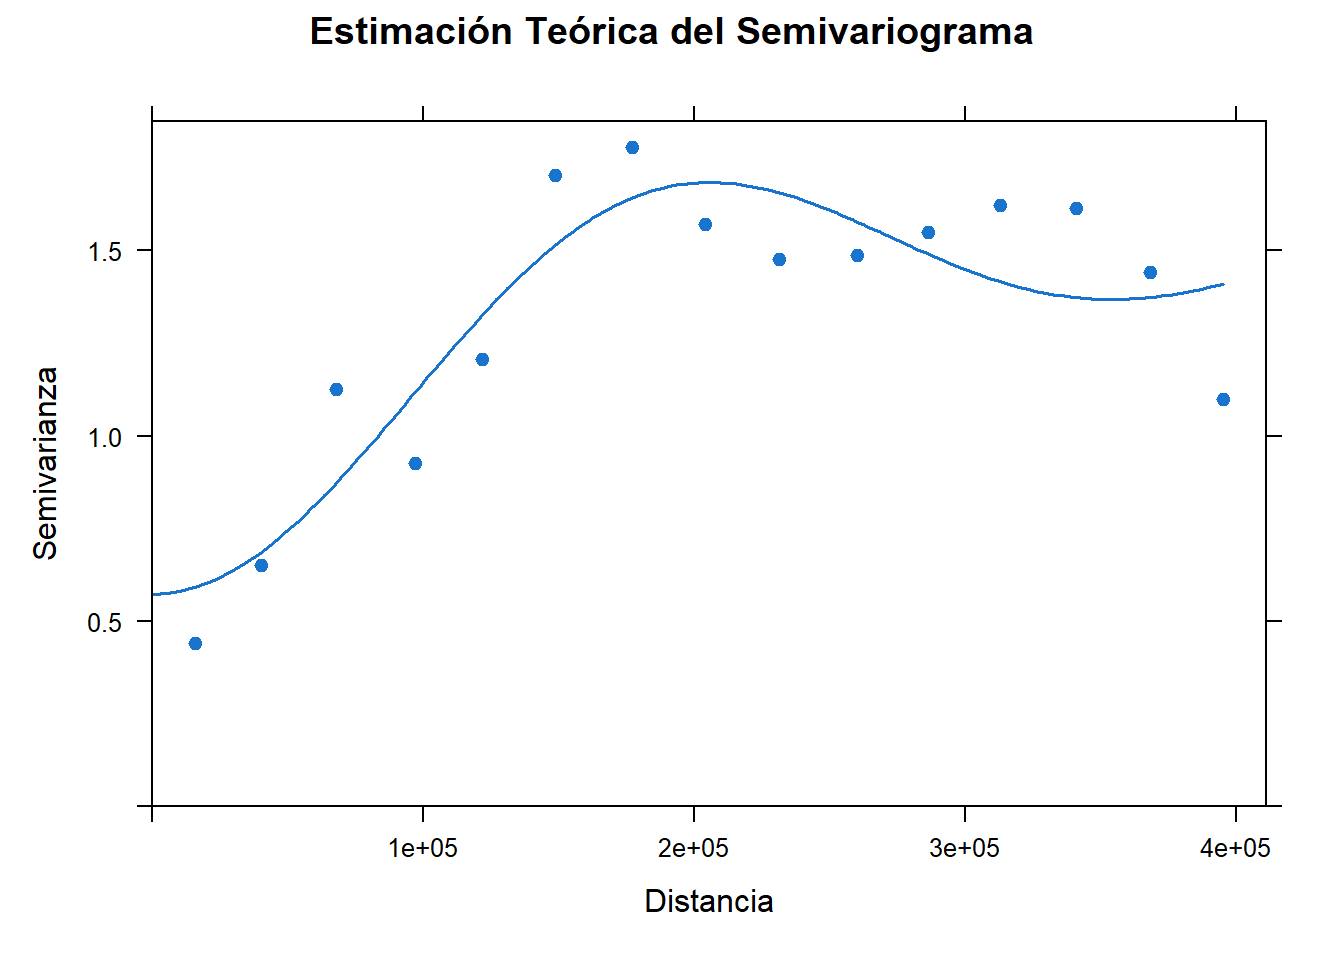
Después de haber obtenido las estimaciones por los distintos métodos, se llega a la conclusión que el mejor modelo corresponde al Wave con los siguientes parámetros:

Parámetros Estimados
Estimación
\(c_0\) 0.57358
\(c_s\) 0.91243
\(a\) 47992.04376

De esta forma, se define el objeto que almacena el modelo y se grafica:

Code
best_par <- coef(nls.wave1)

best_model <- vgm(psill = best_par["cs"], 
                  model = "Wav", 
                  range = 3*best_par["a"], 
                  nugget = best_par["c0"])

plot(vgm, best_model,
     xlab = "Distancia", ylab = "Semivarianza",
     main = "Estimación Teórica del Semivariograma",
     pch = 19, lwd = 1.5, col = "dodgerblue3")

Se define la grilla para realizar la interpolación basada en este modelo.

Code
tx <- states(cb = TRUE, year = 2023) |>
  st_as_sf() |>
  dplyr::filter(STUSPS == "TX") |>
  st_transform(3083)

grid_tx <- st_make_grid(tx, cellsize = 10000, square = TRUE) %>%   # 10 km de resolución
  st_intersection(tx) %>% 
  st_centroid() %>% 
  st_as_sf()

grid <- as.data.frame(st_coordinates(grid_tx))

coordinates(grid) <- ~ X + Y

Y se realiza el kriging:

Code
krige_temp <- gstat::krige(
  formula = Temp ~ X + Y + I(X^2) + I(X^3) + I(Y^3),
  locations = temp.data,
  newdata   = grid,
  model     = best_model, 
  maxdist = 8e5)
[using universal kriging]

Obteniendo los siguientes resultados:

Code
Stations_sp <- as(Stations_sf, "Spatial")

stations_layer <- list(
  "sp.points",
  Stations_sp,
  pch = 21,      
  cex = 1.4,
  bg = viridis(100),
  col = "black")


rng    <- range(krige_temp$var1.pred, na.rm = TRUE)

at_lab <- pretty(rng, n = 10)          

spplot(krige_temp, "var1.pred", colorkey = list(
        right = list(
          fun = draw.colorkey,
          args = list(
            key = list(
              at = at_lab,
              col = viridis(100),
              labels = list(
                at = at_lab
              )
            )
          )
        )
      ), 
      col.regions = viridis(100),
      sp.layout   = list(stations_layer),
      main = "Mapa de Predicción de la Temperatura °C")

Code
rng    <- range(krige_temp$var1.var, na.rm = TRUE)

at_lab <- pretty(rng, n = 10)  

spplot(krige_temp, "var1.var", colorkey = list(
        right = list(
          fun = draw.colorkey,
          args = list(
            key = list(
              at = at_lab,
              col = magma(100),
              labels = list(
                at = at_lab
              )
            )
          )
        )
      ), 
      col.regions = magma(100),
      main = "Error de Predicción de la Temperatura °C")

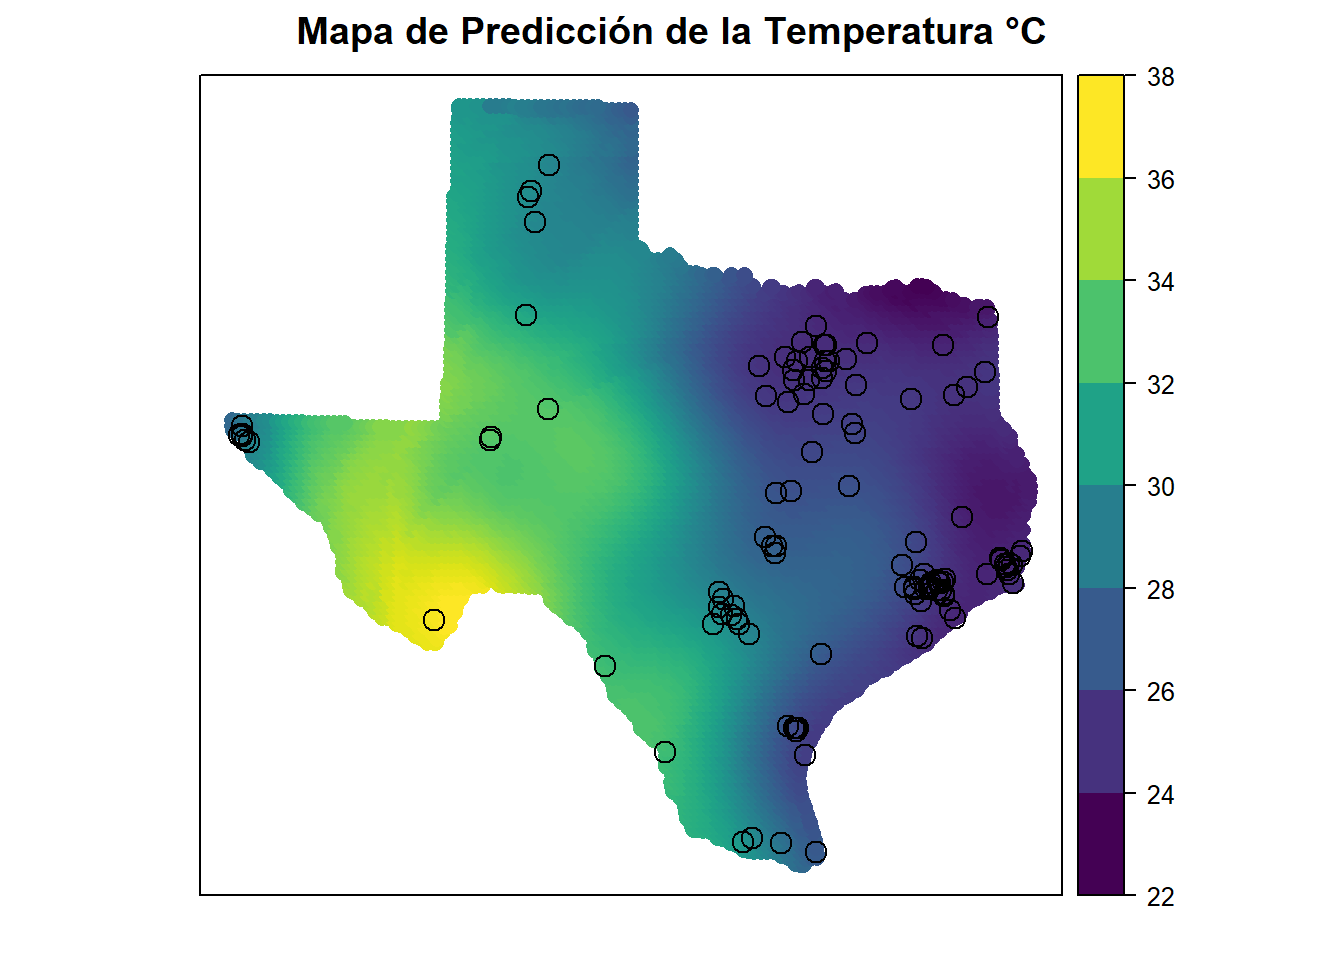
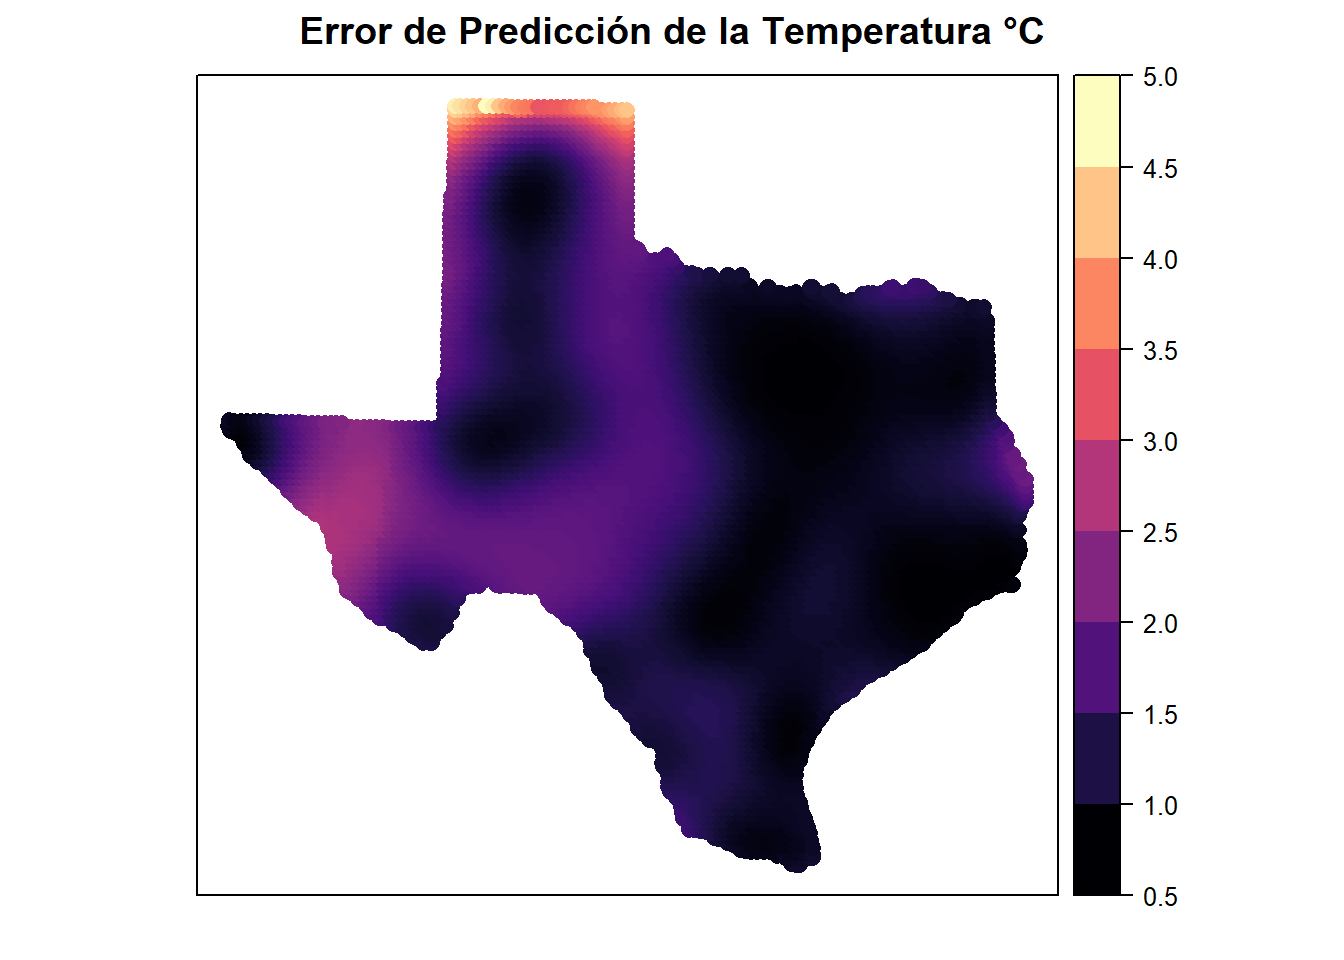
De estos mapas es posible concluir que el oriente de Texas es el lugar donde se obtienen las temperaturas más bajas en comparación con las demás. En el oriente y, más especialmente el suroccidente, presenta las temperaturas más altas llegando incluso a 38 grados centígrados aproxidamente. Con respecto al mapa del error de predicción, como es de esperarse, se presentan errores más altos en los lugares donde no se tienen observaciones, mientras que hay un error menor donde hay bastante presencia de estaciones.

A continuación, se presenta la validación cruzada del kriging (LOOCV) con el modelo escogido.

krige_temp_cv <- krige.cv(formula = Temp ~ X + Y + I(X^2) + I(X^3) + I(Y^3),
                          locations = temp.data,
                          model     = best_model, 
                          maxdist = 8e5)

Y se obtienen las siguientes medidas de evaluación:

metricas_cv <- function(cv) {
  data.frame(
    ME = mean(cv$residual),
    MAE = mean(abs(cv$residual)),
    RMSE = sqrt(mean(cv$residual^2)),
    R2 = 1 - var(cv$residual) / var(cv$observed),
    MPSE = mean(cv@data$residual^2 / cv@data$var1.var),
    COR = cor(cv@data$var1.pred, cv@data$observed)
  )
}

metricas_cv(krige_temp_cv)
          ME       MAE      RMSE        R2      MPSE       COR
1 0.02341561 0.6204751 0.9182373 0.8752771 0.9339834 0.9357251

En conjunto, estos resultados indican un buen desempeño del modelo tanto en términos de precisión como de consistencia. En primer lugar, el Error Medio (ME) es cercano a cero, lo que sugiere que el modelo no tiende a sobreestimar ni subestimar las observaciones.

El MAE y el RMSE, con valores de aproximadamente 6 y 9 unidades respectivamente, muestran que la magnitud de los errores es razonable para la escala de la variable.

Además, el \(R^2\) indica que se está explicando un gran porcentaje de la variabilidad observada. De igual forma la correlación entre los valores observados y los predichos en las estaciones es alta, indicando que se están logrando predicciones de muy buena calidad.