Análisis del Ozono

Descripción

Se muestra el mapa de la distribución espacial de las estaciones en el estado de Texas, Estados Unidos.

Code
OZ <- read.csv("G:/Mi unidad/Camilo UNAL/Estadística Espacial/Proyecto/Datos/TexasOZone2024.csv")

OZ_stations <- OZ %>% 
  distinct(Site.ID, .keep_all = TRUE) %>% 
  dplyr::select(Site.ID, Site.Longitude, Site.Latitude) %>% 
  rename(ID = Site.ID)


coords_sf <- st_as_sf(OZ_stations, coords = c("Site.Longitude", "Site.Latitude"), crs = 4326)

crs_texas <- 3083

coords_proj <- st_transform(coords_sf, crs = crs_texas)

## Coordenadas planas ----

texas_coords <- st_coordinates(coords_proj)

OZ_stations$X <- texas_coords[,1]
OZ_stations$Y <- texas_coords[,2]


OZ <- read.csv("G:/Mi unidad/Camilo UNAL/Estadística Espacial/Proyecto/Primera Entrega/OZ.csv", check.names = FALSE)[,-1]

## Mapa con Datos Ozono ----

OZ_map <- coords_proj %>%
  left_join(OZ, by = "ID") %>% 
  na.omit()

mapview(OZ_map, 
        zcol = "Ozone", 
        legend = TRUE, 
        cex = 7, 
        col.regions = viridisLite::viridis, 
        popup = OZ_map$Site.ID,
        layer.name = "Ozono (ppb)")

Como se puede apreciar, no hay muchas estaciones hacia el noroccidente de Texas. Además de esto, se muestran los valores de Ozono.

Análisis de Estacionariedad

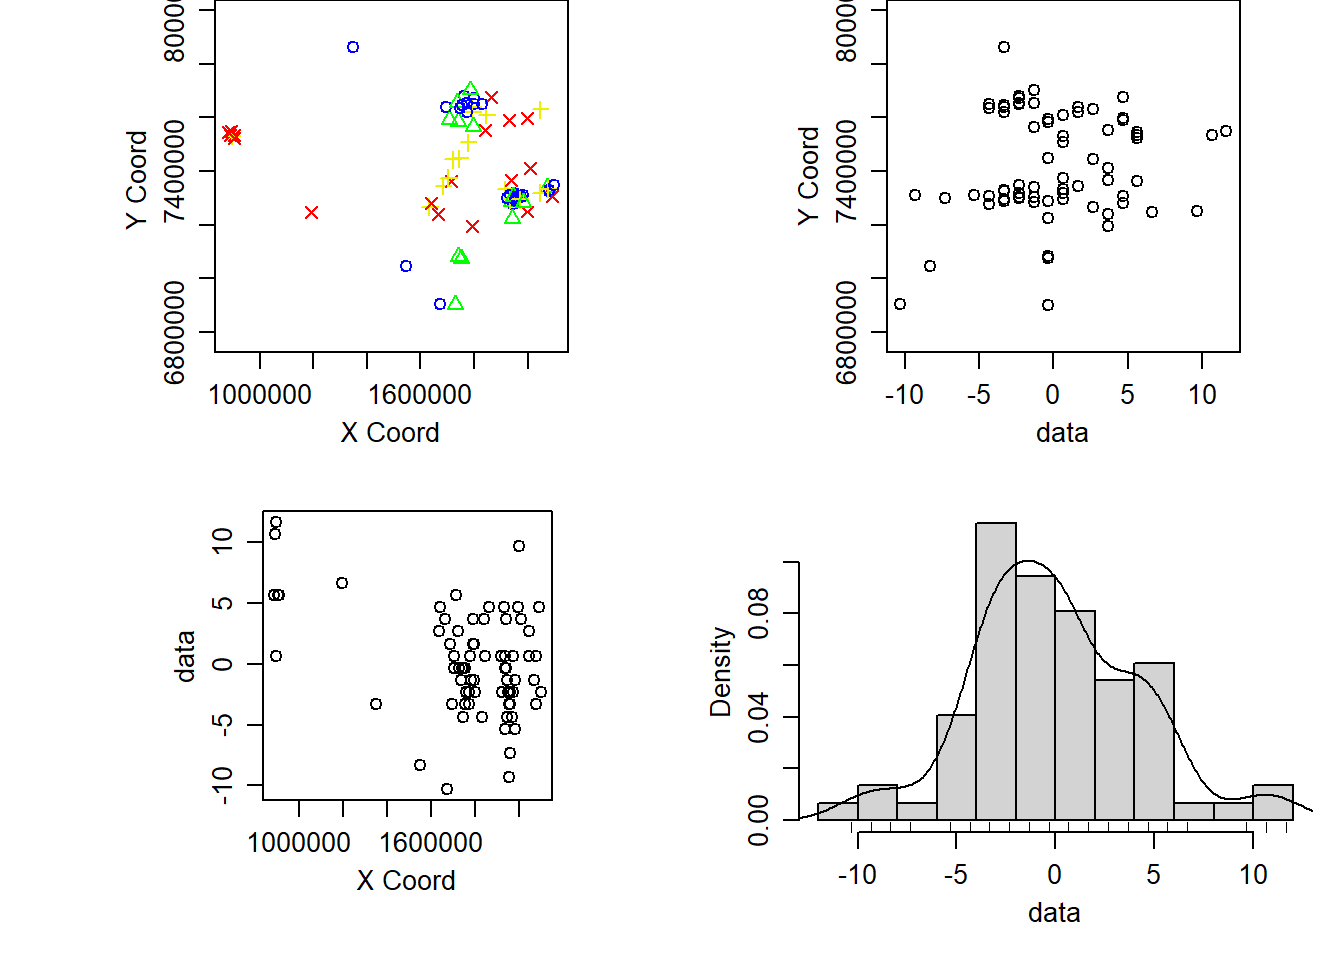
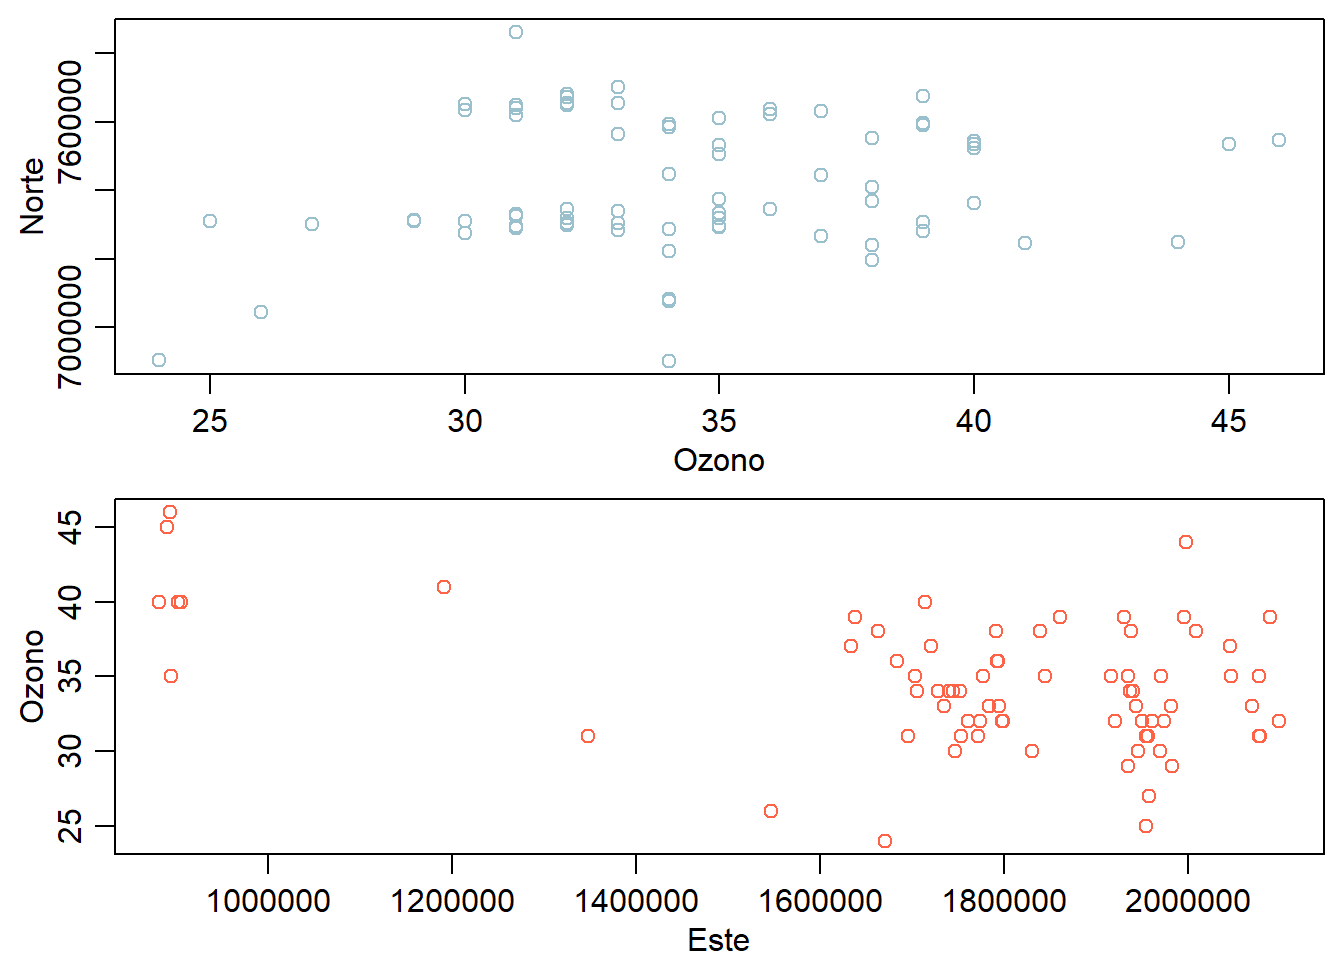
A continuación se presenta el resúmen visual de los datos de Ozono en Texas. De igual forma, también se muestra el gráfico del Ozono vs Coordenadas.

OZ$OzC <- residuals(lm(Ozone ~ 1, data = OZ))

OZg <- as.geodata(OZ,
                  coords.col = 2:3,
                  data.col = 5)

plot(OZg)

par(mfrow = c(2, 1), mar = c(2.75, 3, 0.5, 0.5), mgp = c(1.7, 0.7, 0))

plot(x = OZ$Ozone, y = OZ$Northing,
     xlab = "Ozono", ylab = "Norte",
     col = "lightblue3")

plot(x = OZ$Easting, y = OZ$Ozone,
     xlab = "Este", ylab = "Ozono",
     col = "tomato")

De estos gráficos es posible ver que la variable presenta estacionariedad con respecto a la media y, además, no se evidencian problemas con respecto a heteroscedasticidad. Por lo tanto, no es necesario ajustar un modelo lineal para intentar alcanzar estacionariedad.

Semivariograma

A pesar de haber ajustado el modelo lineal, el Ozono en Texas parece ser estacionario desde un comienzo. De esta forma, se halla el semivariograma empírico para estos dos casos.

Datos originales

variog: computing omnidirectional variogram

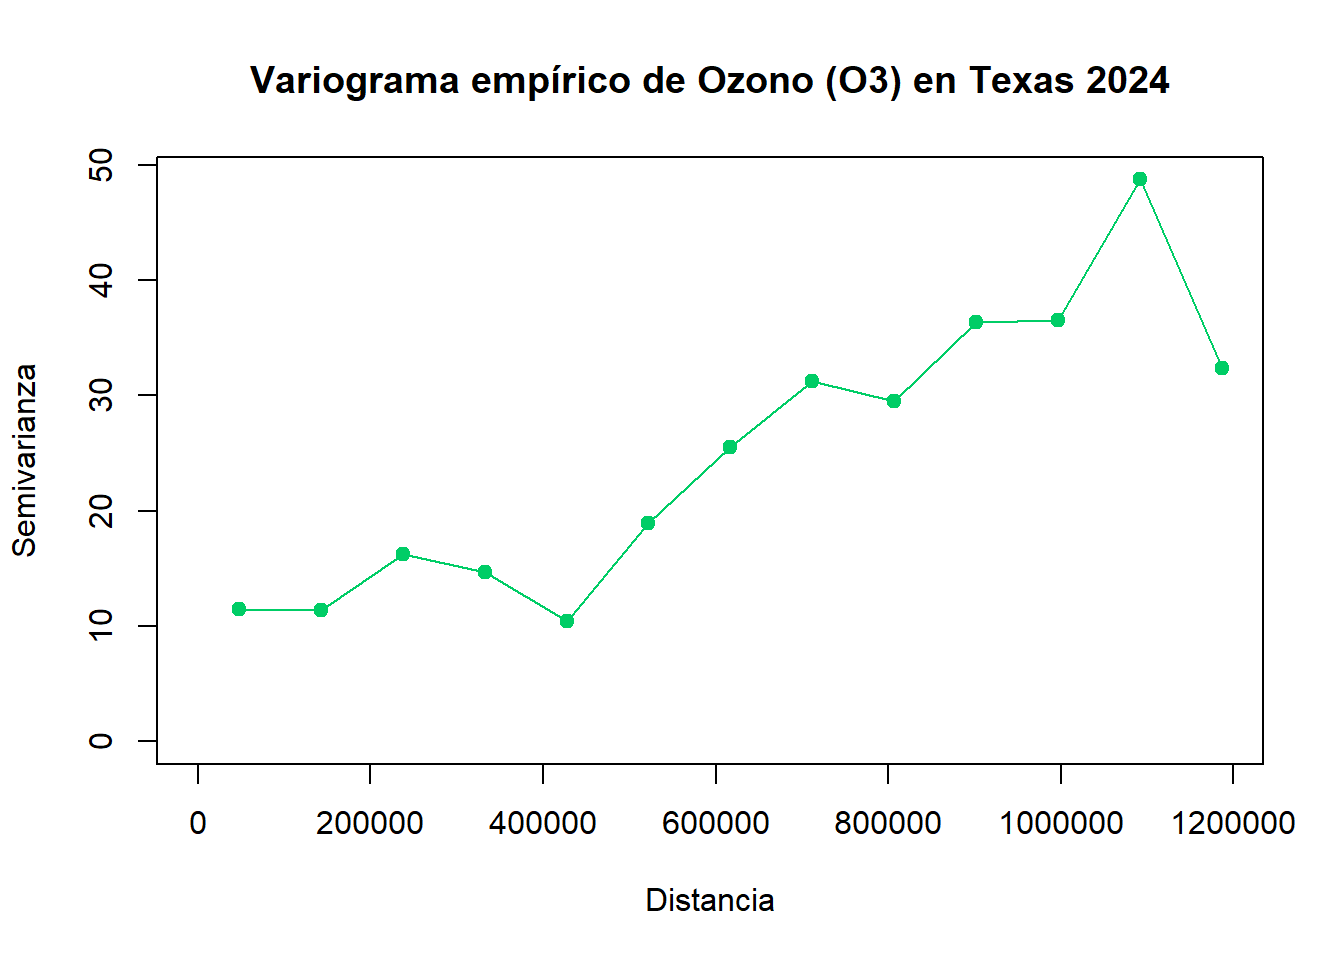
Como se espera, a puntos cercanos hay menor variabilidad en cuanto a la semivarianza. Se puede ver que se presenta un efecto pepita pequeño, pues la semivarianza no pasa por el orígen. Además, se puede ver que el rango ocurre en aproximadamente \(400.000\) unidades de distancia.

Resistente a datos atípicos

variog: computing omnidirectional variogram

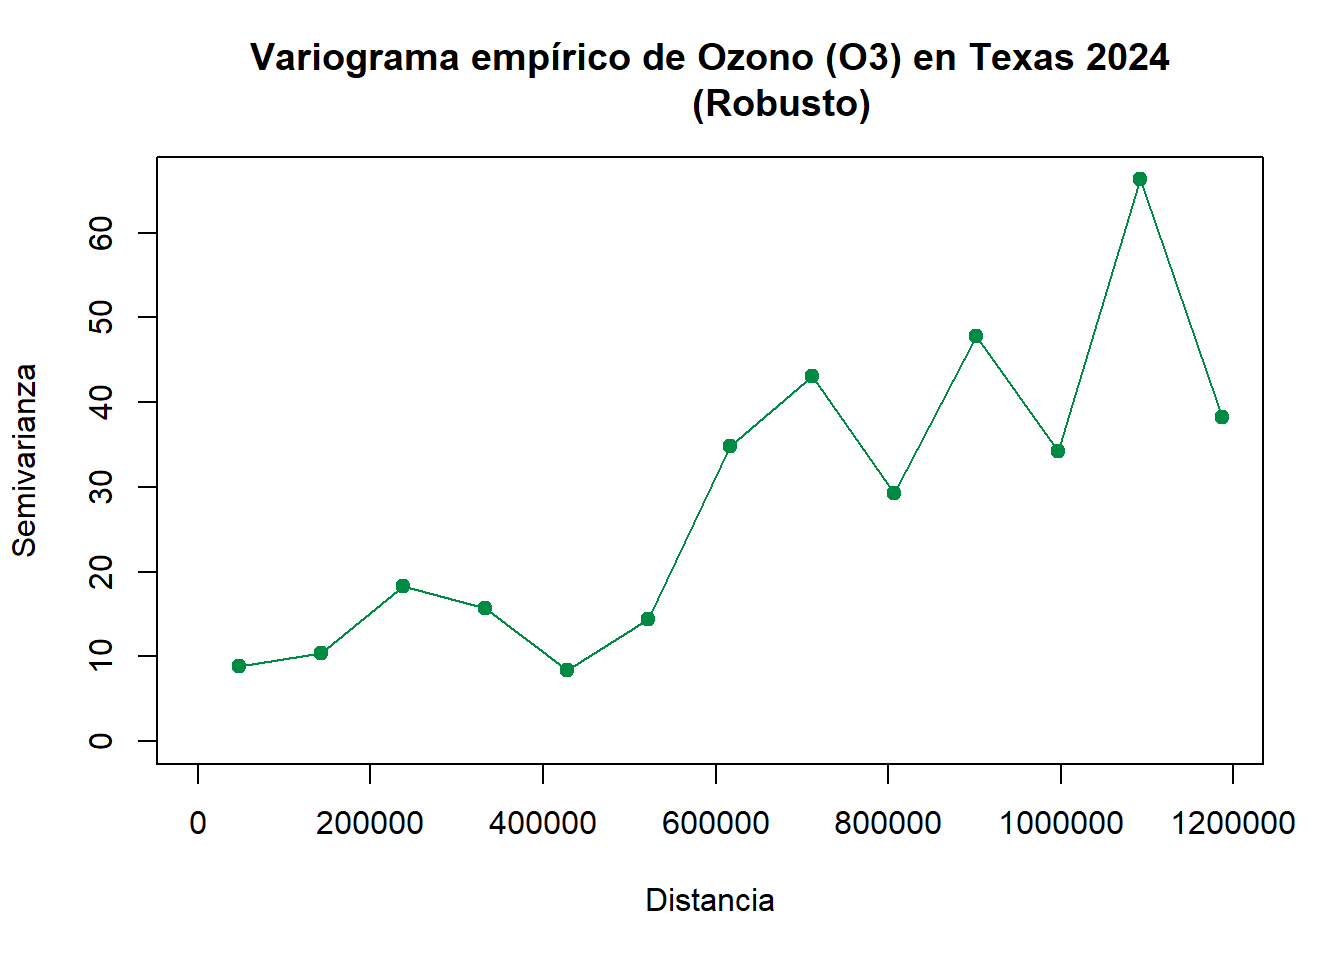
Es posible ver que es similar al semivariograma basado en el promedio. Esto se puede estar dando debido a que no hay presencia de datos atípicos que estén afectando el nivel medio de la variable.

Estimación teórica del semivariograma

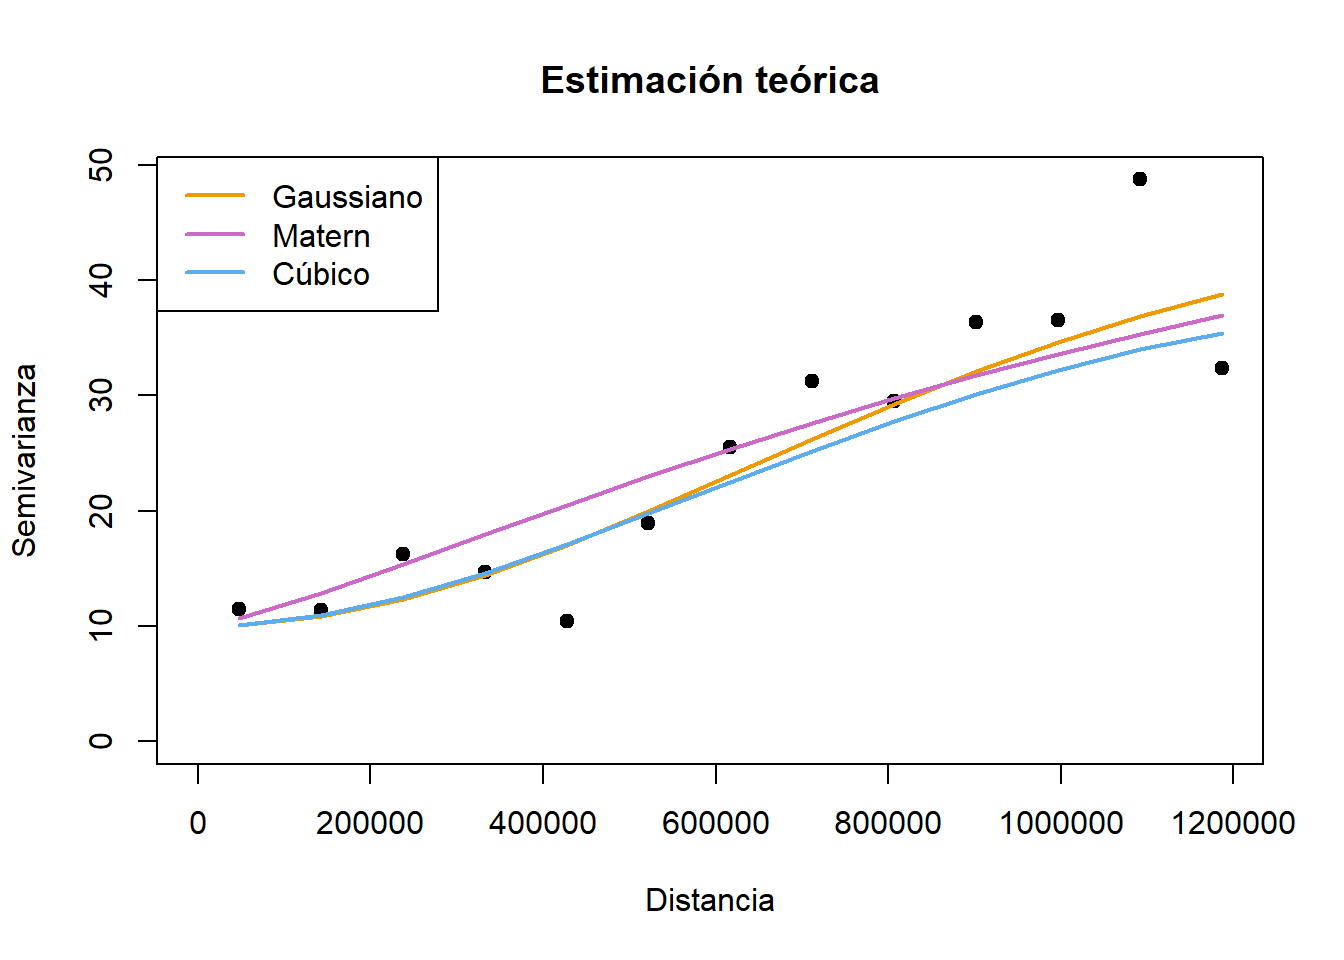
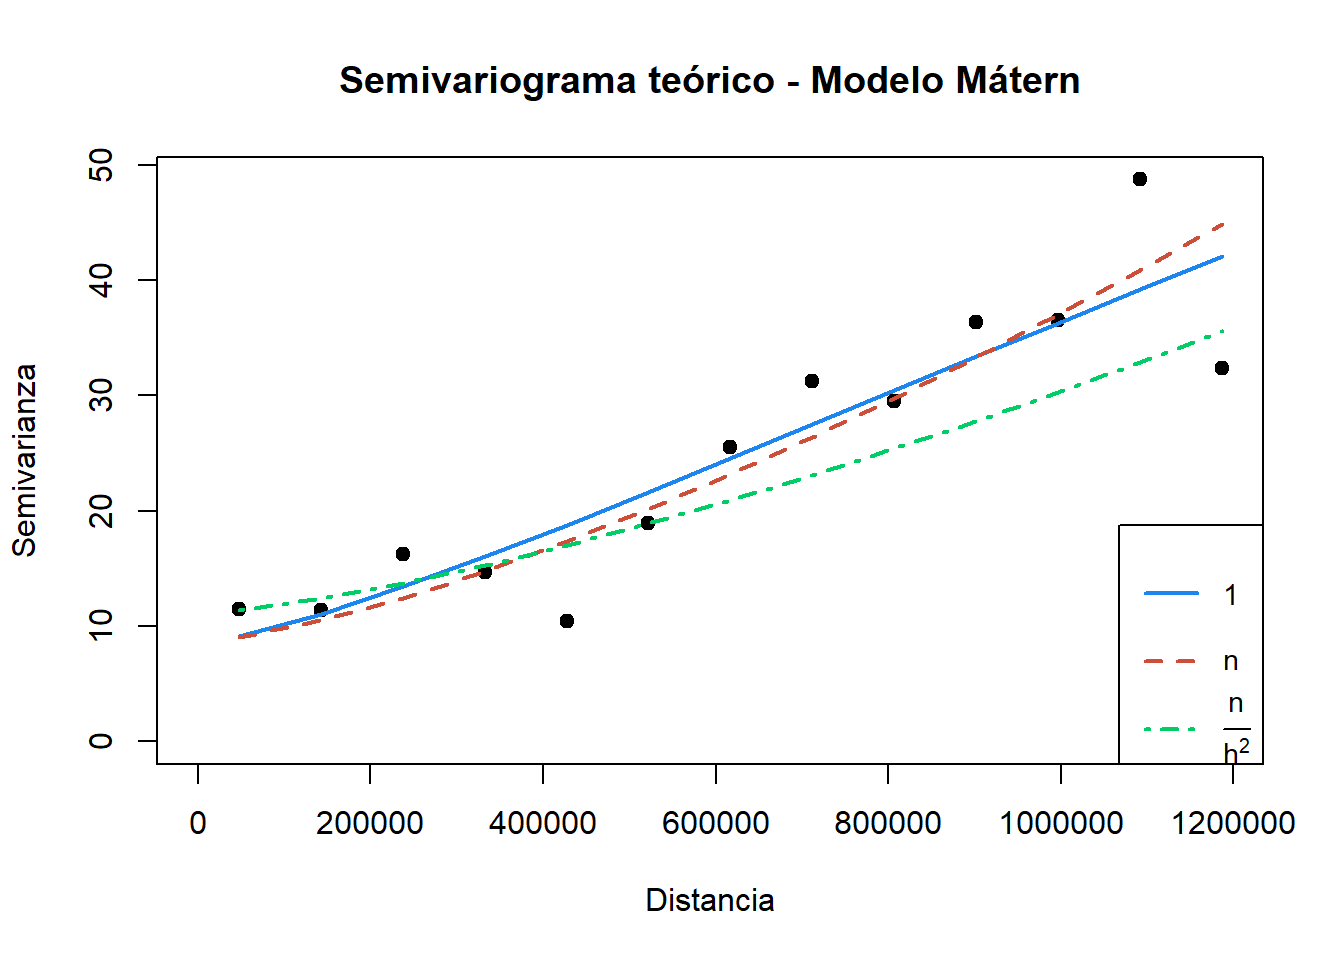
Con base en la sección de Modelos válidos para el semivariograma, vemos que los que más se asimilan al semivariograma empírico son el Gaussiano, Cúbico y Matern.

Por lo tanto, con ayuda de la función eyefit, inicialmente ajustamos a “ojo” los parámetros del modelo gaussiano que se ajusta a los datos de Ozono:

Code
init_gau <- c(c0 = 10, cs = 34.88, a = 9e+05)
init_mat <- c(c0 = 10, cs = 46.5, a = 1036220.5, kappa = 0.7)
init_cub <- c(c0 = 10, cs = 28.42, a = 1727035.38)

Entonces, los semivariogramas con estos parámetros iniciales se ven de la siguiente forma:

Code
gamma_gaus <- function(h, c0, cs, a){
  ifelse(h == 0,
         0,
         c0 + cs*(1 - exp(-(h/a)^2)))
}


gamma_mat <- function(h, c0, cs, a, kappa){
  ifelse(h == 0,
         0,
         c0 + cs * (1 - ((h / a)^kappa * besselK(h / a, nu = kappa)) /
                      (2^(kappa - 1) * gamma(kappa)))
  )
}

gamma_cub <- function(h, c0, cs, a) {
  ifelse(
    h == 0, 
    0,
    ifelse(
      h <= a,  
      c0 + cs * (7*(h/a)^2 - 8.75*(h/a)^3 + 3.5*(h/a)^5 - 0.75*(h/a)^7),
      c0 + cs   
    )
  )
}

MSE <- function(fitted, observed){
  
  mean((fitted - observed)^2)
  
}

Regresión No Lineal

Ahora, con los valores iniciales escogidos anteriormente, realizamos la estimación de los parámetros mediante regresión no lineal.

Code
library(minpack.lm)

data_OZ <- data.frame(h = vargrm1$u,
                      gamma_est = vargrm1$v,
                      n = vargrm1$n)


# Gausiano
nls.gaus1 <- nls(gamma_est ~ gamma_gaus(h, c0, cs, a),
                 data = data_OZ,
                 start = as.list(init_gau))

nls.gaus2 <- nls(gamma_est ~ gamma_gaus(h, c0, cs, a),
                  data = data_OZ,
                  start = as.list(init_gau),
                  weights = n)

nls.gaus3 <- nlsLM(gamma_est ~ gamma_gaus(h, c0, cs, a),
                   data = data_OZ, 
                   start = as.list(init_gau),
                   weights = (n/h^2),
                   control = nls.lm.control(maxiter=1000, ftol=1e-10, ptol=1e-10))


# Cúbico

nls.cub1 <- nls(gamma_est ~ gamma_cub(h, c0, cs, a),
                data = data_OZ,
                start = as.list(init_cub))

nls.cub2 <- nls(gamma_est ~ gamma_cub(h, c0, cs, a),
                data = data_OZ,
                start = as.list(init_cub), 
                weights = n)

nls.cub3 <- nlsLM(gamma_est ~ gamma_cub(h, c0, cs, a),
                  data = data_OZ, 
                  start = as.list(init_cub),
                  weights = (n/h^2),
                  control = nls.lm.control(maxiter=1000, ftol=1e-10, ptol=1e-10))
# Mátern

nls.mat1 <- nls(gamma_est ~ gamma_mat(h, c0, cs, a, kappa = 0.7),
                data = data_OZ,
                start = as.list(init_mat[-4]))

nls.mat2 <- nlsLM(gamma_est ~ gamma_mat(h, c0, cs, a, kappa = 0.7),
                 data = data_OZ,
                 start = as.list(init_mat[-4]), 
                 weights = n,
                 control = nls.lm.control(maxiter=1000, ftol=1e-10, ptol=1e-10))

nls.mat3 <- nlsLM(gamma_est ~ gamma_mat(h, c0, cs, a, kappa = 0.7),
                  data = data_OZ, 
                  start = as.list(init_mat[-4]),
                  weights = (n/h^2),
                  control = nls.lm.control(maxiter=1000, ftol=1e-10, ptol=1e-10))
Modelo MSE Peso
Gausiano 20.0814 \(1\)
Gausiano 26.8063 \(n\)
Gausiano 30.9100 \(\frac{n}{h^2}\)
Cúbico 20.4941 \(1\)
Cúbico 28.4781 \(n\)
Cúbico 30.8811 \(\frac{n}{h^2}\)
Mátern 23.2330 \(1\)
Mátern 25.1138 \(n\)
Mátern 40.6334 \(\frac{n}{h^2}\)

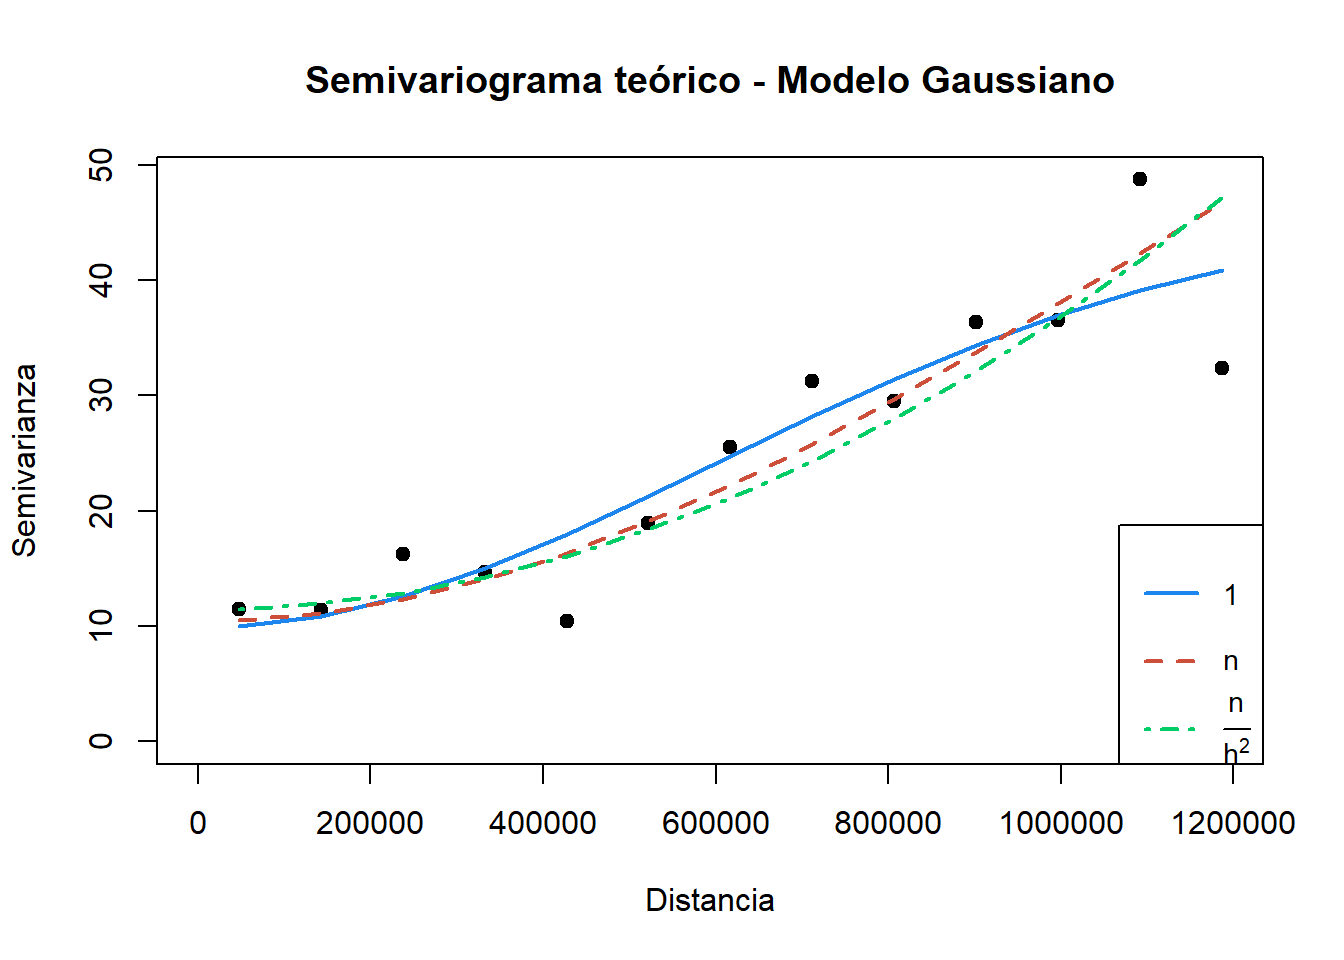
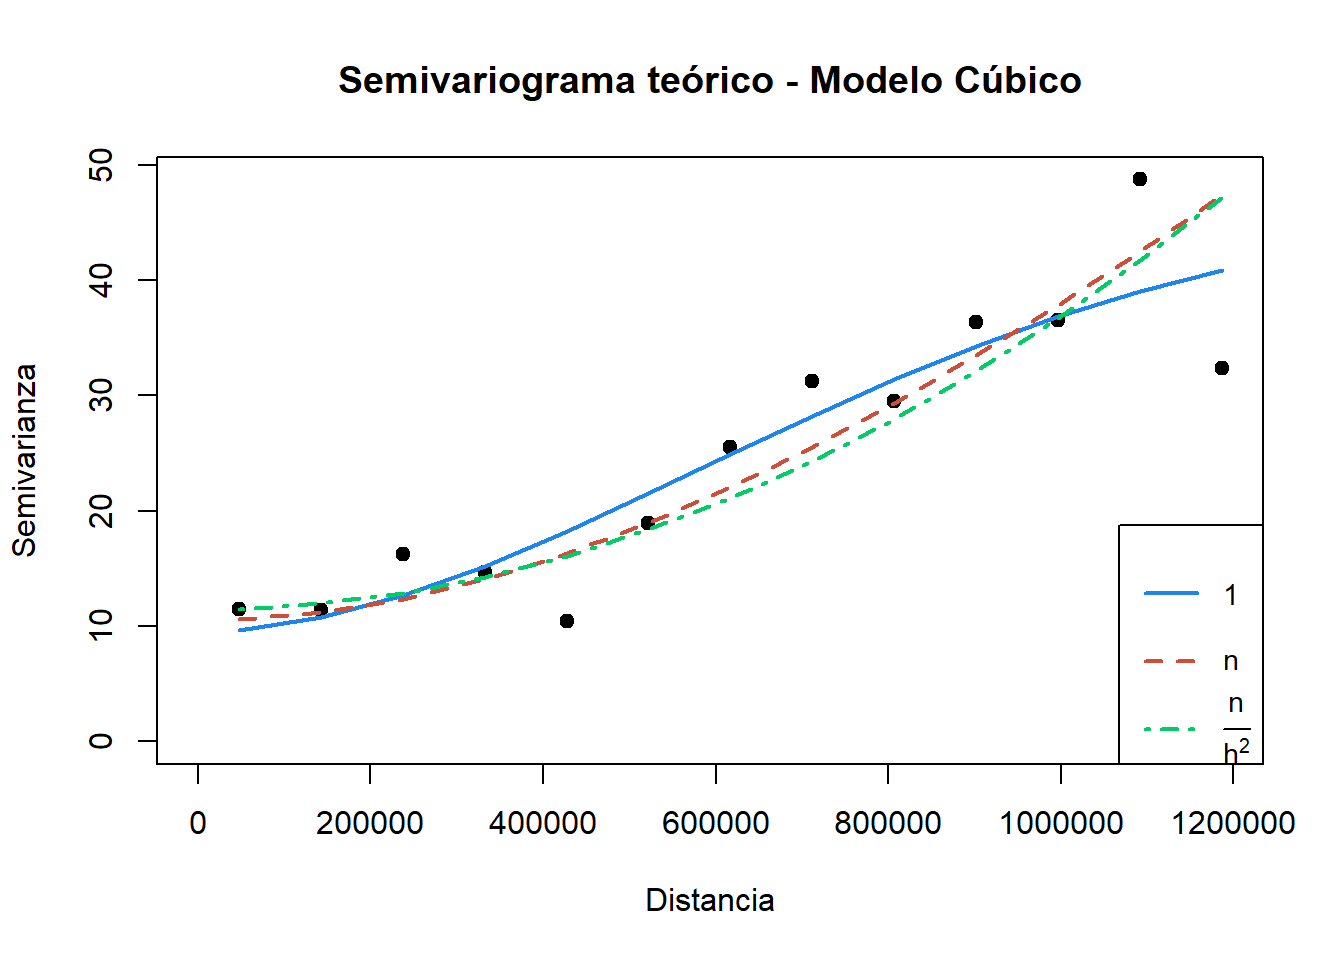
Además de comparar las gráficas de los mejores

Tanto con la gráfica como con el MSE, nos damos cuenta que el modelo no lineal en el que no se considera una matriz de ponderación se ajusta de mejor forma al semivariograma empírico. Se presentan los coeficientes estimados por este método:

Warning in kable_styling(., position = "center", full_width = FALSE): Please
specify format in kable. kableExtra can customize either HTML or LaTeX outputs.
See https://haozhu233.github.io/kableExtra/ for details.
Mejor modelo no lineal
Parámetro Estimación
\(c_0\) 9.852
\(c_s\) 36.0693
\(a\) 845089.1454

Cressie

Se define la función que nos ayudará a realizar la estimación de los parámetros de los distintos modelos.

Code
Q_cressie <- function(par, data, gamma_fun, kappa = NULL, eps = 1e-12){
  
  g <- if (is.null(kappa)) {
    gamma_fun(h = data$h, c0 = par["c0"], cs = par["cs"], a = par["a"])
    
  } else {
    
    gamma_fun(h = data$h, c0 = par["c0"], cs = par["cs"], a = par["a"], kappa = kappa)
    
  }
  
  g2 <- pmax(g^2, eps)         
  
  sum( data$n * (data$gamma_hat - g)^2 / (2 * g2), na.rm = TRUE )
}


fit_cressie <- function(gamma_fun, start, data,
                        lower = c(c0=0, cs=0, a=.Machine$double.eps),
                        upper = c(c0=Inf, cs=Inf, a=Inf),
                        kappa = NULL){
  
  par0 <- start[c("c0","cs","a")]    
  
  opt <- optim(par = par0, fn = Q_cressie, method = "L-BFGS-B",
               lower = lower, upper = upper,
               data = data, gamma_fun = gamma_fun, kappa = kappa)
  
  
  p  <- opt$par
  
  g  <- if (is.null(kappa)) {
    gamma_fun(data$h, p["c0"], p["cs"], p["a"])
  } else {
    gamma_fun(data$h, p["c0"], p["cs"], p["a"], kappa)
  }    
  
  mse <- MSE(g, data$gamma_est)
  
  list(par = p, converged = (opt$convergence==0),
       fitted = g, MSE = mse, kappa = kappa)
}

De esta forma, aplicamos la función a cada modelo haciendo uso, además, de optim. Vea que en este caso, la matriz de ponderaciones cambia con cada iteración.

Los resultados se presentan a continuación:

Modelo MSE
Cúbico 178.8011
Gausiano 22.7620
Mátern 28.8839

Como es posible apreciar, de nuevo el modelo Gausiano nos muestra un mejor ajuste. Aún así, el ajuste obtenido por nls fue mejor.

Máxima Verosimilitud

Primero, es importante considerar las funciones de Covarianza de los modelos que se están considerando para la variable de Ozono. Además de esto, también se define una función general que permite usar la función de log-verosimilitud en general para poder realizar la optimización.

Code
cov.gaus <- function(h, c0, cs, a){
  ifelse(h == 0,
         c0 + cs,
         cs * exp(-(h/a)^2))
}

cov.mat <- function(h, c0, cs, a, kappa = 1.35){
  ifelse(h == 0,
         c0 + cs,
         cs * (1 - (1 - ((h / a)^kappa * besselK(h / a, nu = kappa)) /
                 (2^(kappa - 1) * gamma(kappa)))))
}

loglik.model <- function(par, Z, coords, cov.model) {
  c0 <- par[1]  
  cs <- par[2]   
  a  <- par[3]   
  
  
  h <- as.matrix(dist(coords))
  
  
  Sigma <- cov.model(h, c0, cs, a)
  
  
  n <- length(Z)
  L <- try(chol(Sigma), silent = TRUE)
  if (inherits(L, "try-error")) return(1e6)
  
  
  SinvZ <- backsolve(L, forwardsolve(t(L), Z))
  
  logdet <- 2 * sum(log(diag(L)))
  nll <- 0.5 * (n * log(2*pi) + logdet + sum(Z * SinvZ))
  
  return(nll)  
}

De esta forma, se realiza el ajuste por máxima verosimilitud con la función optim.

Code
coordinates(OZ) <- ~ Easting + Northing

mv.gaus <- optim(
  par = coef(nls.gaus1),
  fn = loglik.model,
  Z = OZ$OzC,
  coords = coordinates(OZ),
  cov.model = cov.gaus,
  method = "L-BFGS-B",
  lower = c(0, 0, 0)
)

mv.gaus <- within(mv.gaus, {
  MSE        <- with(as.list(par), MSE(gamma_gaus(data_OZ$h, c0, cs, a), data_OZ$gamma_est))
  gamma_pred <- with(as.list(par), gamma_gaus(data_OZ$h, c0, cs, a))
})


mv.mat <- optim(
  par = init_mat,
  fn = loglik.model,
  Z = OZ$OzC,
  coords = coordinates(OZ),
  cov.model = cov.mat,
  method = "L-BFGS-B",
  lower = c(0, 0, 0)
)

mv.mat <- within(mv.mat, {
  MSE        <- with(as.list(par), MSE(gamma_mat(data_OZ$h, c0, cs, a, kappa = 0.7), data_OZ$gamma_est))
  gamma_pred <- with(as.list(par), gamma_mat(data_OZ$h, c0, cs, a, kappa = 0.7))
})

Y se presentan los resultados:

Comparación de estimaciones MV
Modelo MSE
Gausiano 26.7394
Matern 127.5045

Kriging Ordinario

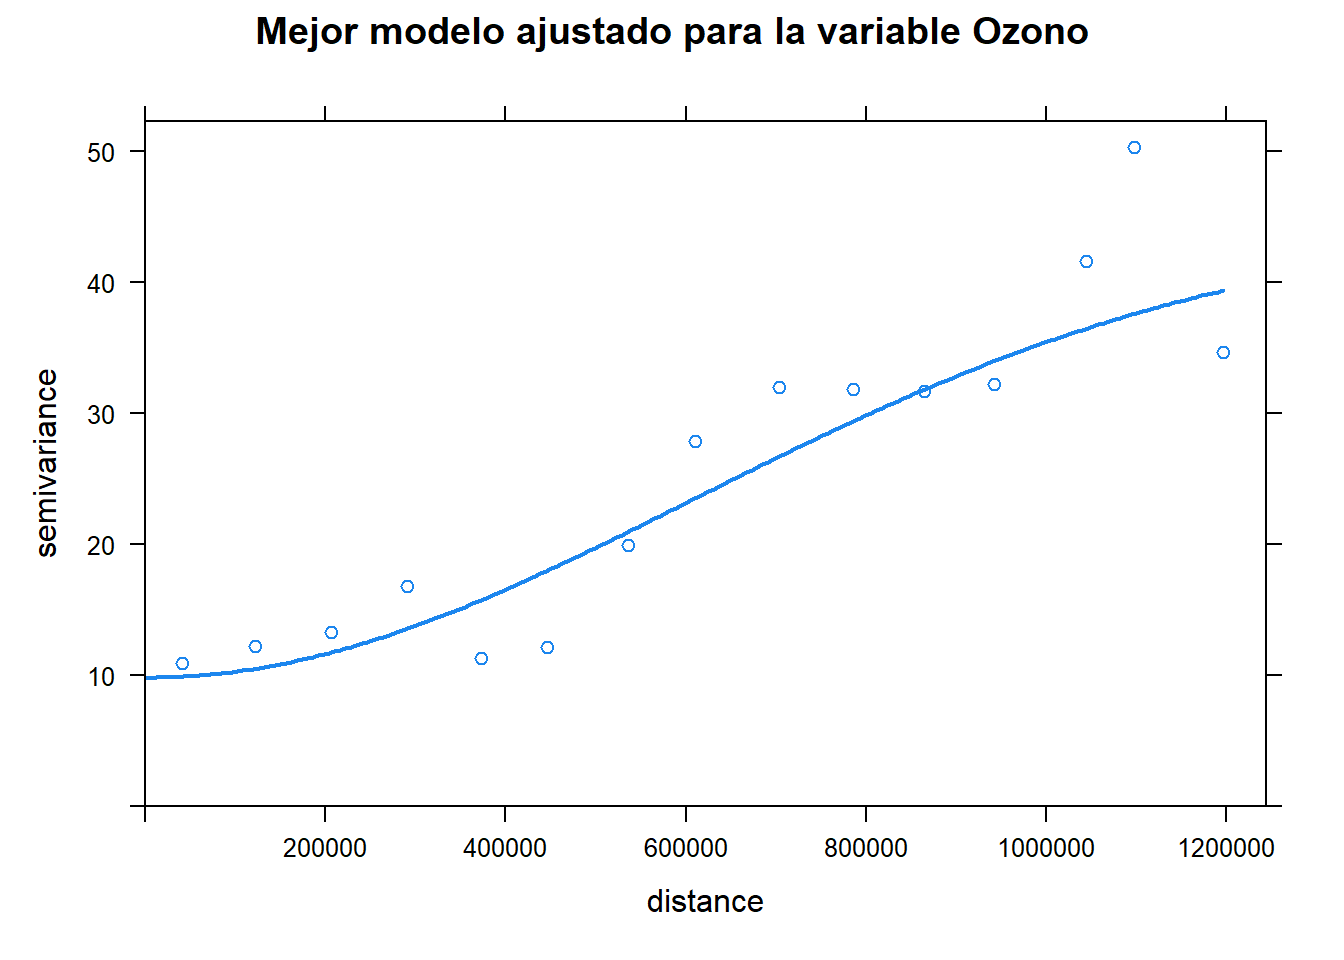
Basado en los resultados pasados, vimos que el mejor modelo fue el Gausiano con la estimación de los parámetros a través de la función nls.

Primero, se genera la grilla de valores para poder realizar la interpolación.

grid <- read.csv("grid.csv", check.names = FALSE)

coordinates(grid) <- ~ X + Y

Veamos primero el modelo ajustado.

Code
best_model <- vgm(psill = 34.509, 
                  model = "Gau", 
                  range = 857720.5474, 
                  nugget = 9.8194)


vgm <- variogram(Ozone ~ 1, data = OZ, cutoff = max(dist(coordinates(OZ))))

plot(vgm, best_model, 
     lwd = 2, col = "dodgerblue2",
     main = "Mejor modelo ajustado para la variable Ozono")

Y se realiza el kriging ordinario basado en este modelo.

Code
krige.oz <- gstat::krige(
  Ozone ~ 1,
  locations = OZ,
  newdata = grid,
  model = best_model, maxdist = 1/3 * max(dist(coordinates(OZ))), nmax = 60)
[using ordinary kriging]
Code
Stations_sp <- as(coords_proj, "Spatial")

stations_layer <- list(
  "sp.points",
  Stations_sp,
  pch = 21,      
  cex = 1.6,
  bg = viridis(100),
  col = "black")

rng    <- range(krige.oz$var1.pred, na.rm = TRUE)

at_lab <- pretty(rng, n = 10)          

spplot(krige.oz, "var1.pred", colorkey = list(
        right = list(
          fun = draw.colorkey,
          args = list(
            key = list(
              at = at_lab,
              col = viridis(100),
              labels = list(
                at = at_lab
              )
            )
          )
        )
      ), 
      col.regions = viridis(100),
      sp.layout   = list(stations_layer),
      main = "Mapa de Predicción del Ozono (ppb)")

Code
stations_layer <- list(
  "sp.points",
  Stations_sp,
  pch = 21,      
  cex = 1.6,
  bg = viridis(100),
  col = "white")

rng    <- range(krige.oz$var1.var, na.rm = TRUE)

at_lab <- pretty(rng, n = 10)  

spplot(krige.oz, "var1.var", colorkey = list(
        right = list(
          fun = draw.colorkey,
          args = list(
            key = list(
              at = at_lab,
              col = magma(100),
              labels = list(
                at = at_lab
              )
            )
          )
        )
      ), 
      col.regions = magma(100),
      sp.layout   = list(stations_layer),
      main = "Error de Predicción del Ozono (ppb)")

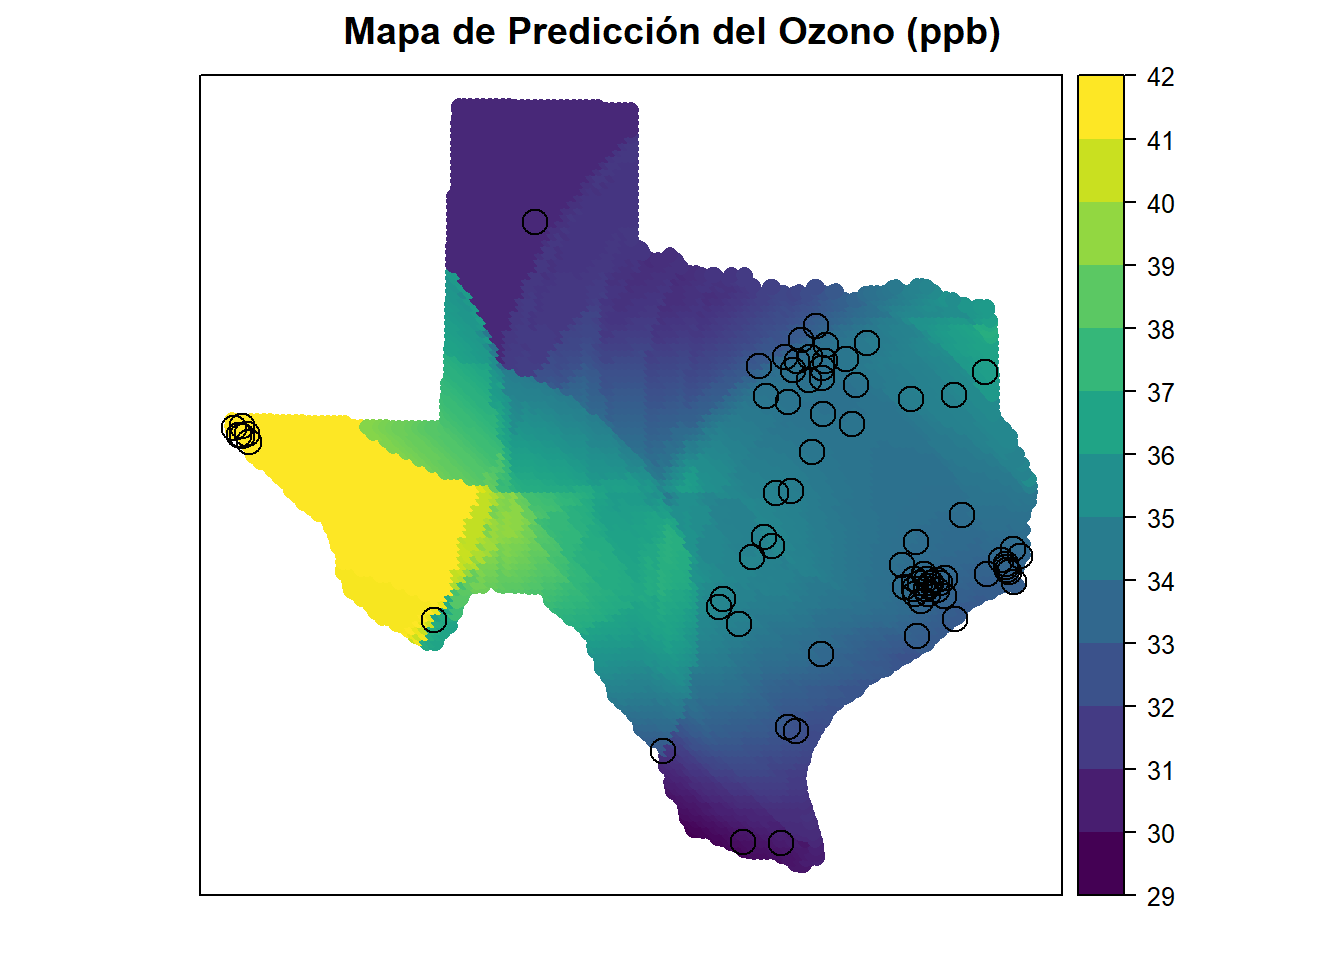
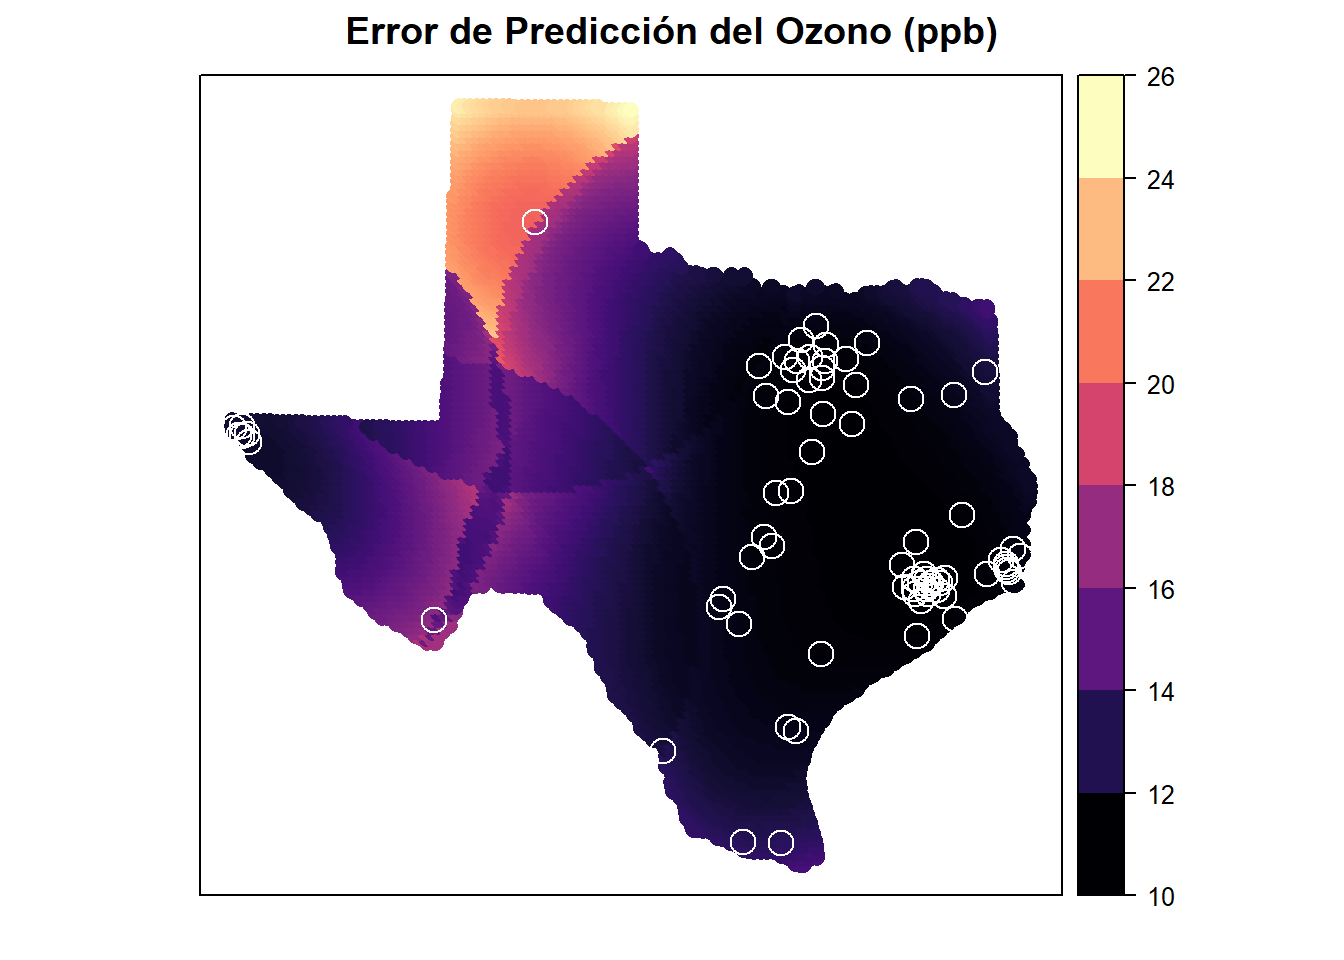
Es posible ver que en hacia el occidente de Texas se presentan los valores más bajos de Ozono, mientras que en el oriente y, más especificamente hacia el suroriente, se presentan los valores más altos de ozono. Además, como es de esperarse, los errores de predicción más bajos se encuentran sobre la zona donde se tienen más estaciones, mientras que los más altos donde se tienen pocas.