Análisis de Datos Funcionales

Objetivos

Objetivo general

Analizar las estructuras temporales y espaciales de las variables PM2.5 y ozono en el estado de Texas durante el año 2024 mediante técnicas de análisis de datos funcionales (FDA), con el fin de construir un modelo de covarianza espacial basado en componentes principales funcionales (FPCA) que permita realizar predicciones espacialmente coherentes de ambas variables.


Objetivos específicos

  • Construir las curvas funcionales de PM2.5 y temperatura mediante un proceso de suavizamiento basado en bases B-splines cúbicas, estimando el parámetro de penalización λ mediante validación cruzada.

  • Aplicar el Análisis de Componentes Principales Funcionales (FPCA) para obtener los scores funcionales y estudiar la estructura de variabilidad dominante en las curvas diarias.

  • Modelar la dependencia espacial de los scores funcionales mediante la construcción del semivariograma empírico y el ajuste de modelos teóricos (Exponencial, Wave, Cúbico).

  • Implementar Kriging Funcional para generar mapas de predicción espacial y de incertidumbre, utilizando los componentes principales y la estructura de covarianza estimada, con el propósito de representar la distribución esperada de PM2.5 y ozono y evaluar la precisión de las estimaciones.

Descripción

Primero se cargan los datos y se muestra la estructura general que ellos tienen. En las filas se encuentra cada uno de los tiempos y en las columnas se encuentran las estaciones.

OZ_st_pvt <- read.csv("OZ_data_imputed.csv",
                      check.names = FALSE)

OZ_st_pvt <- OZ_st_pvt %>%
  mutate(across(where(is.numeric), ~ .x * 1000))

head(OZ_st_pvt, c(10, 5)) %>% kable(format = "pandoc", escape = FALSE)
Date 480271045 480271047 480290032 480290052
01/01/2024 26 26.59725 30 29
01/02/2024 23 19.40062 15 18
01/03/2024 23 24.05877 24 25
01/04/2024 37 33.97910 25 25
01/05/2024 32 33.00000 33 35
01/06/2024 27 30.00000 34 34
01/07/2024 38 40.00000 43 43
01/08/2024 36 38.00000 36 37
01/09/2024 36 37.00000 33 31
01/10/2024 36 37.04478 35 37

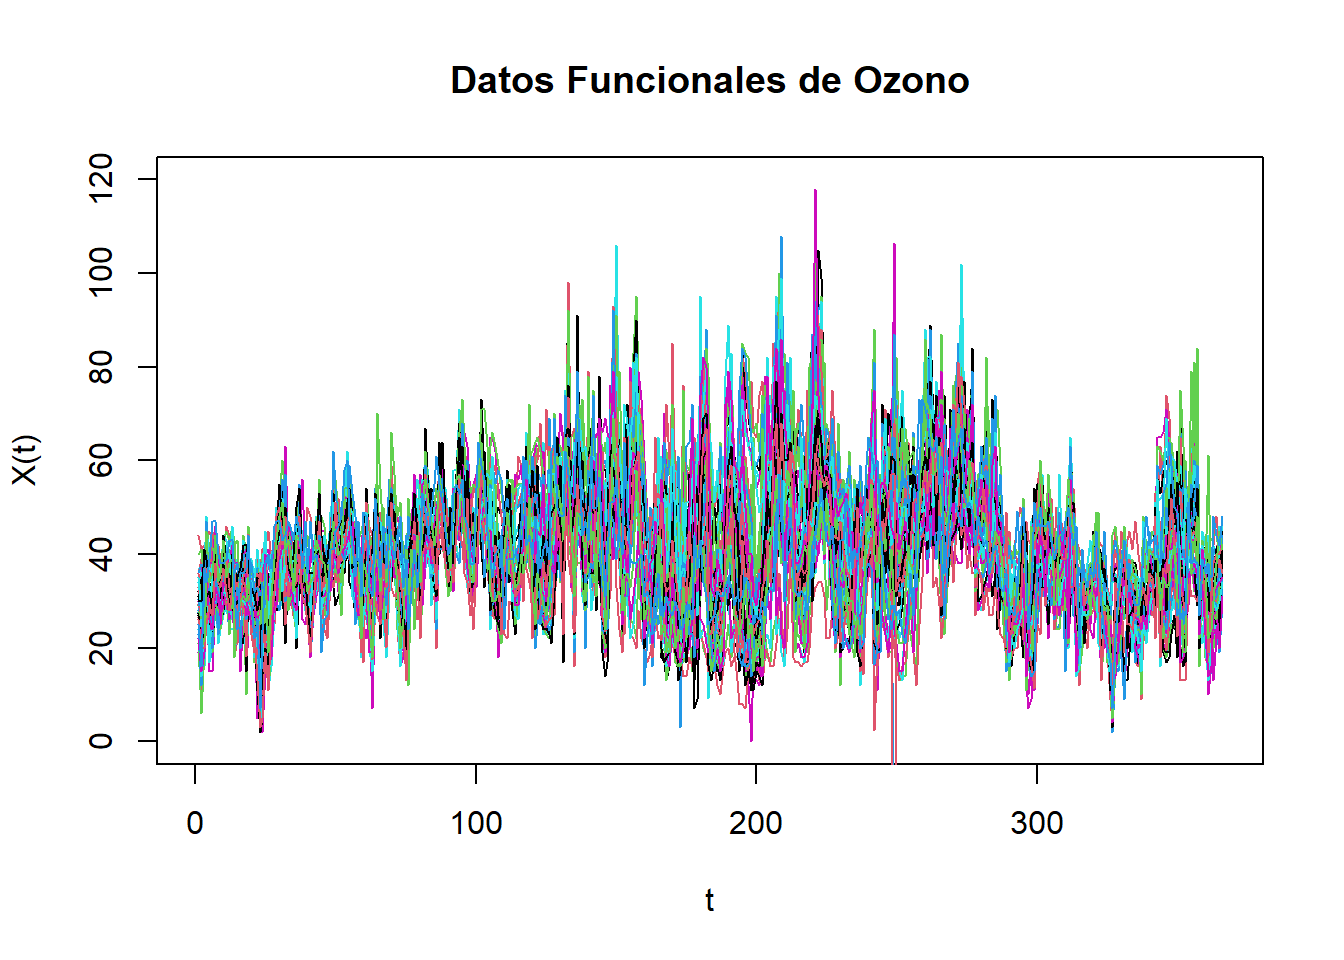
De esta forma, convertimos este objeto a una matriz y se convierte en un objeto funcional.

OZ_num <- OZ_st_pvt[,-1]
OZ.matrix <- as.matrix(OZ_num)

OZ.fd <- fdata(t(OZ.matrix), argvals = 1:nrow(OZ.matrix))

plot(OZ.fd, main = "Datos Funcionales de Ozono", ylim = c(0, 120))

B-Splines

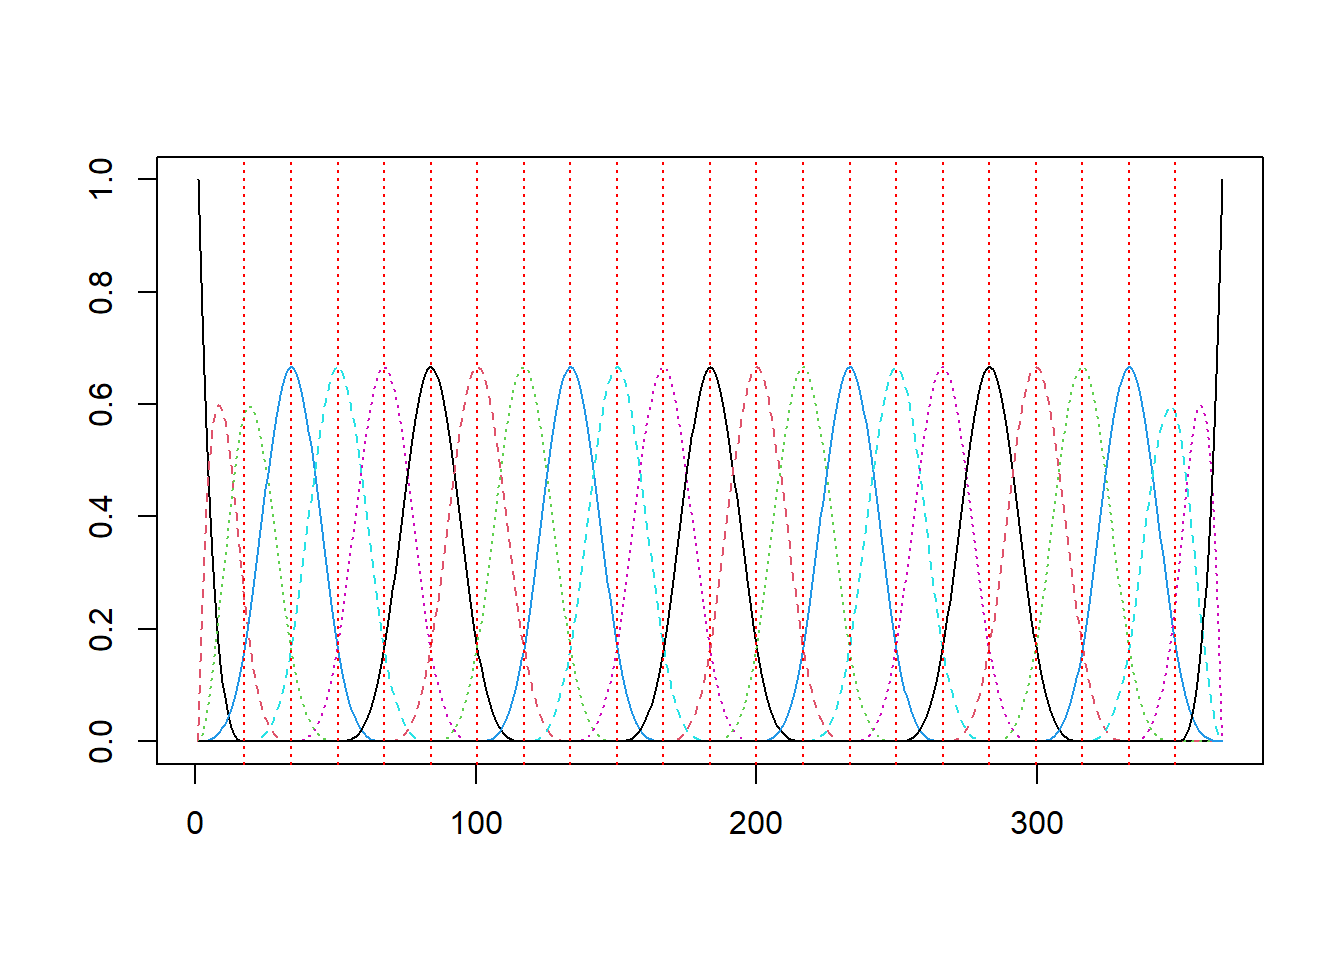
Se eligen a los B-Splines como la base de funciones con la cual se va a trabajar. En la figura se puede apreciar las funciones y el tamaño de la base (\(K=25\)).

nbasis <- 25

dayrange <- c(1, nrow(OZ.matrix))
dailybasis <- create.fourier.basis(dayrange,period=366/365,nbasis)
harmaccelLfd <- vec2Lfd(c(1,76), dayrange)

BSpl <- create.bspline.basis(dayrange, nbasis)
plot(BSpl)

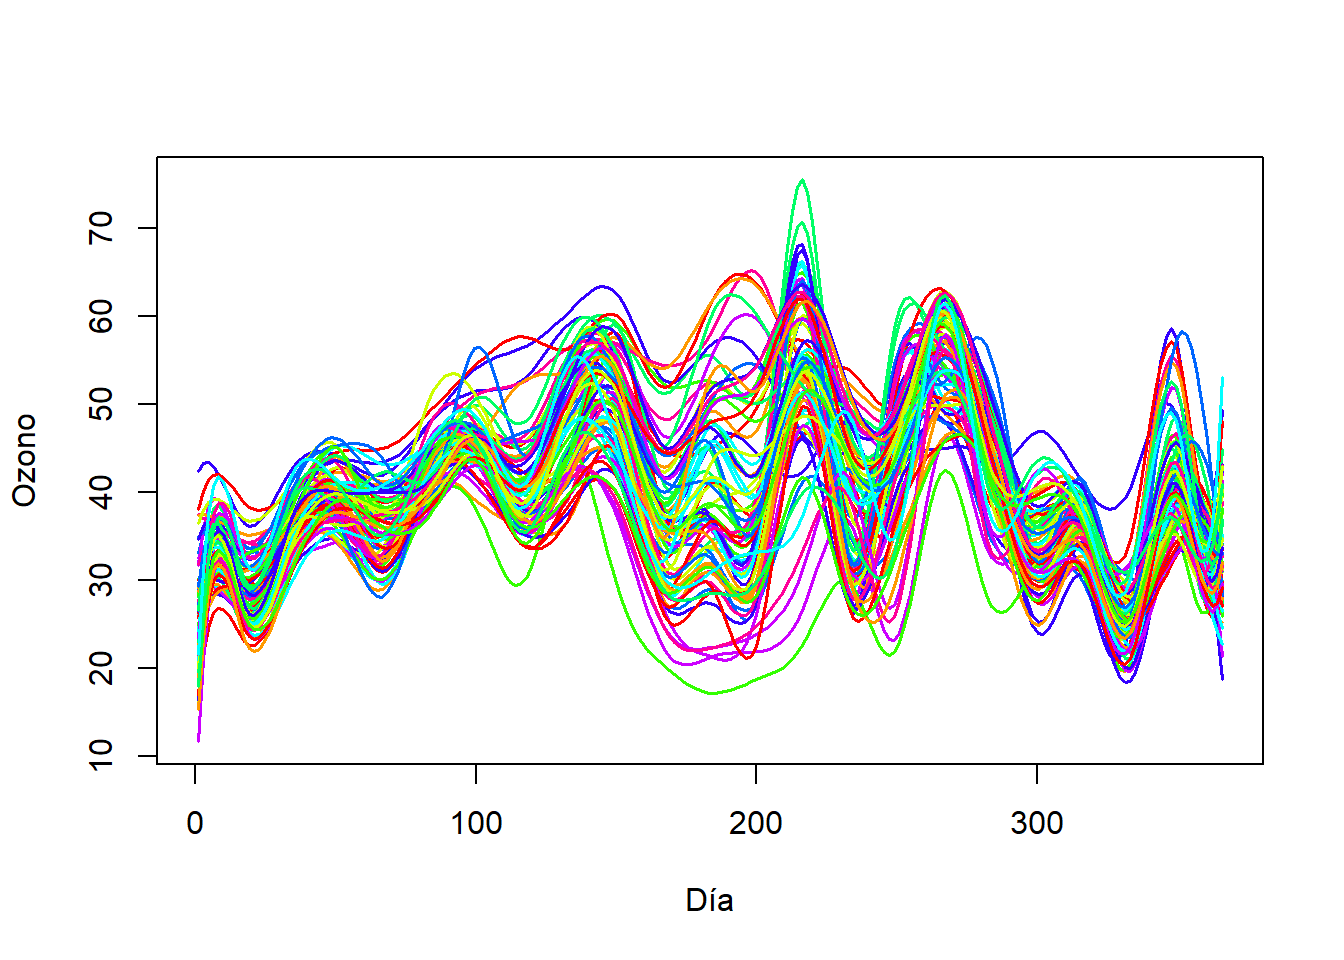
Por lo tanto, se obtienen las curvas con los datos de Ozono. De esta forma, se observa que son similares a los datos funcionales observados.

OZ.fdPar_Bspline <- fdPar(fdobj = BSpl, Lfdobj = harmaccelLfd)

OZ.fd_Bspline <- smooth.basis(argvals = 1:nrow(OZ.matrix), OZ.matrix, OZ.fdPar_Bspline)
OZ.fd_Bspl <- OZ.fd_Bspline$fd

plot(OZ.fd_Bspl, col = "white", xlab = "Día", ylab = "Ozono")
[1] "done"
lines(OZ.fd_Bspl,col=rainbow(10),lwd=1.5,lty=1)

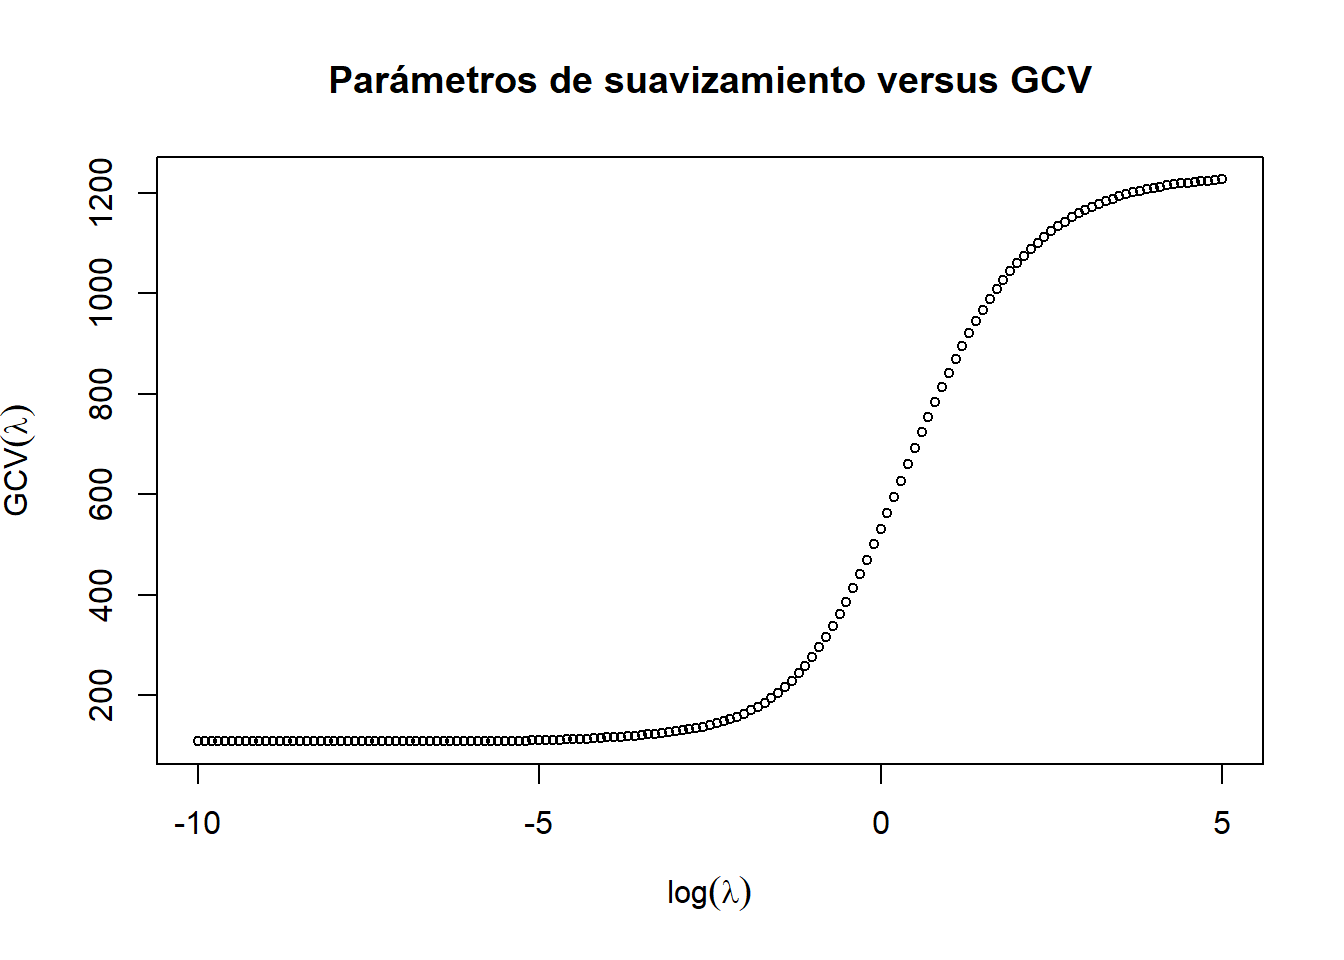
Para hallar un buen valor del parámetro de suavizamiento \(\lambda\), se realiza validación cruzada generalizada (GCV) de la siguiente forma.

loglam <- seq(-10, 5, by = 0.1)
nlam   <- length(loglam)
gcvsave <- numeric(nlam)

for (ilam in 1:nlam) {
  lambda   <- exp(loglam[ilam])
  fdParobj <- fdPar(BSpl, Lfdobj = harmaccelLfd, lambda = lambda)
  
  smoothlist <- smooth.basis(argvals = 1:366, y = OZ.matrix, fdParobj)
  
  gcvsave[ilam] <- mean(smoothlist$gcv)
}


plot(loglam, gcvsave, type = "b", cex = 0.7,
     xlab = expression(log(lambda)),
     ylab = expression(GCV(lambda)),
     main = "Parámetros de suavizamiento versus GCV")

best.idx     <- which.min(gcvsave)
best.loglam  <- loglam[best.idx]
best.lambda  <- exp(best.loglam)
#best.lambda #0.001661557

Obteniendo que

\(\lambda_{GCV}\)
0.0016616

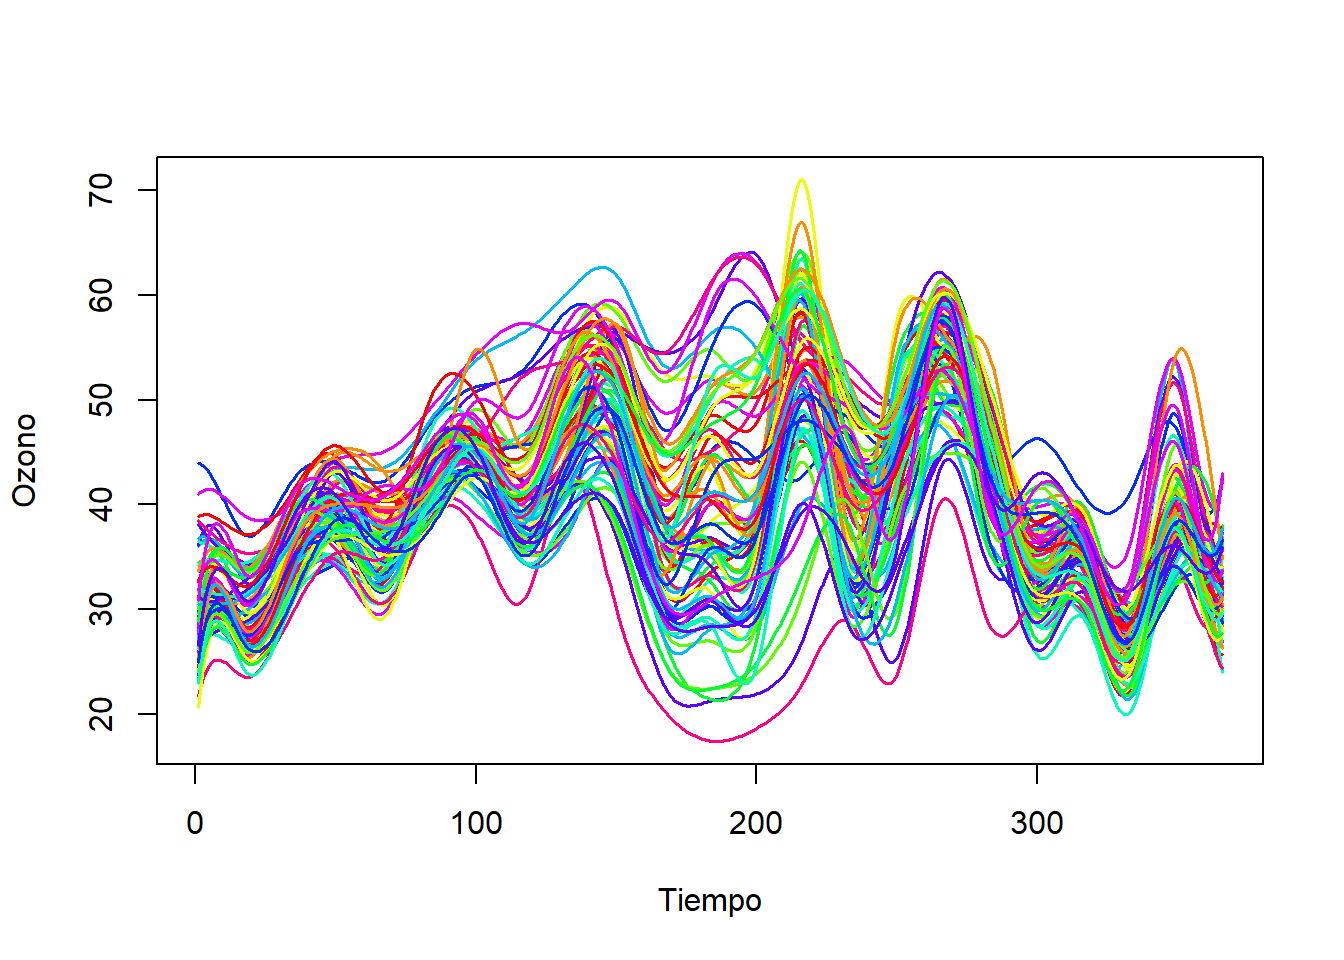
De esta forma se vuelven a ajustar estas curvas, pero con este parámetro de suavizamiento. Obteniendo el siguiente resultado:

OZ.fdPar_Bspline <- fdPar(fdobj = BSpl, 
                            Lfdobj = harmaccelLfd, 
                            lambda = best.lambda)

OZ.fd_Bspline <- smooth.basis(argvals = 1:nrow(OZ.matrix),
                                y = OZ.matrix, 
                                fdParobj = OZ.fdPar_Bspline)

OZ.fd_Bspl <- OZ.fd_Bspline$fd

plot(OZ.fd_Bspl, col = rainbow(11), lwd = 1.5, lty = 1,
     xlab = "Tiempo", ylab = "Ozono")

[1] "done"

PCA

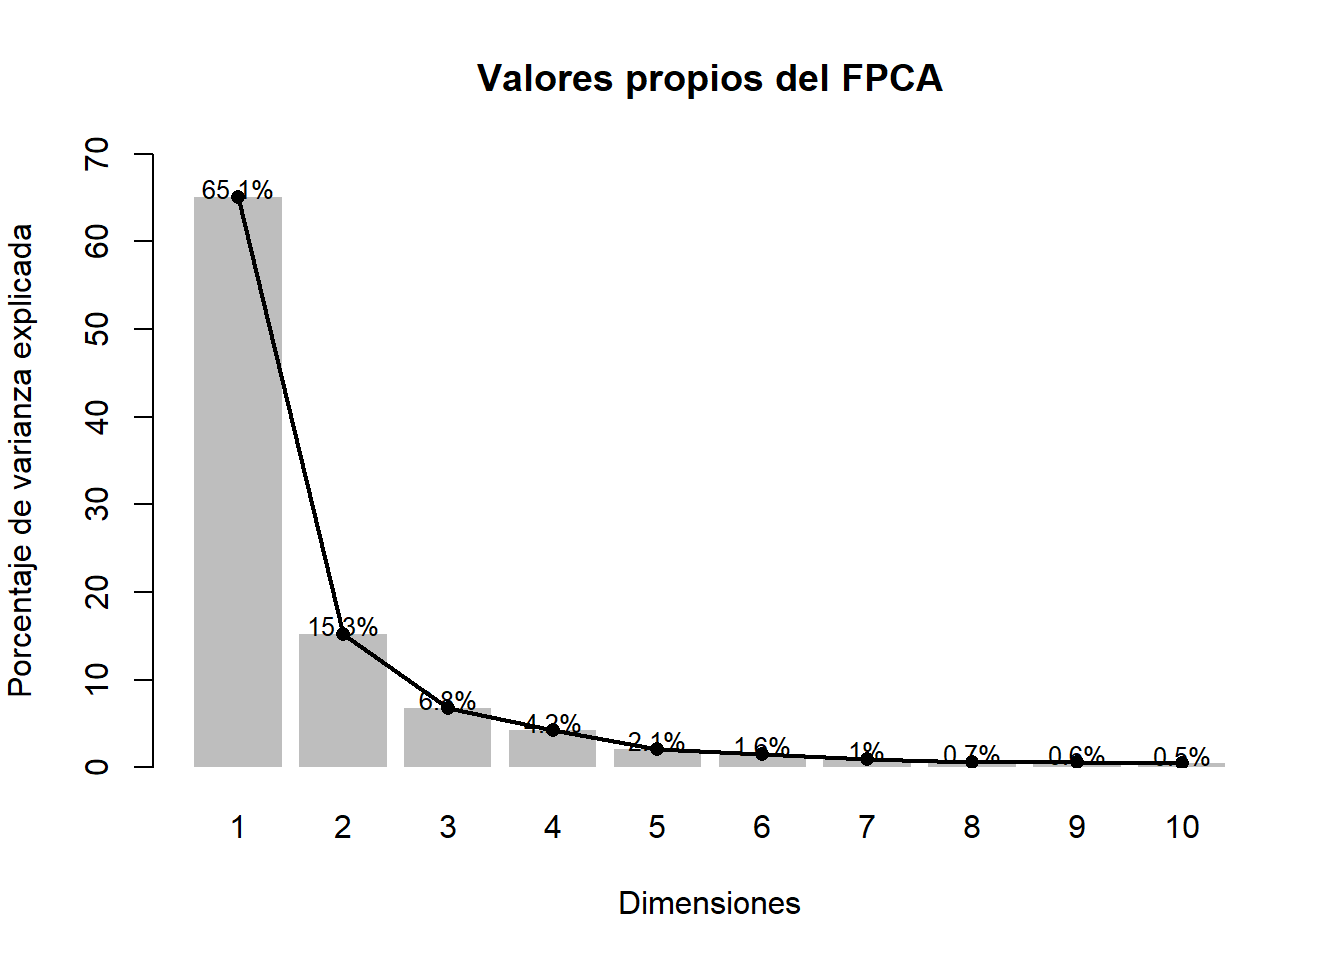
Ahora, se realiza un análisis de componentes principales. En este caso, se puede notar que únicamente con las dos primeras componentes se puede obtener un porcentaje de varianza explicado del 80% aproximadamente.

OZ.fd_PCA <- pca.fd(OZ.fd_Bspl, centerfns = TRUE, nharm = 10)
Dim <- 1:10

Perc <- as.numeric(round(OZ.fd_PCA$varprop * 100, 2))

par(mar = c(5, 4, 4, 2))

barplot(
  Perc,
  names.arg = Dim,
  border = NA,
  ylim = c(0, max(Perc) + 5),
  main = "Valores propios del FPCA",
  xlab = "Dimensiones",
  ylab = "Porcentaje de varianza explicada"
)


bp <- barplot(Perc, plot = FALSE)


lines(bp, Perc, lwd = 2)


points(bp, Perc, pch = 16)


text(bp, Perc + 1, paste0(round(Perc, 1), "%"), cex = 0.8)

Por lo tanto, guardamos estos scores con el fin de poder realizar kriging funcional de las curvas en lugares no muestreados.

OZ.fd_PCA <- pca.fd(OZ.fd_Bspl, centerfns = TRUE, nharm = 2)


OZ_stations <- read.csv("OZ_Stations.csv", check.names = FALSE)


puntaje <- OZ.fd_PCA$scores
colnames(puntaje) <- c("f1","f2")
rownames(puntaje) <- colnames(OZ_st_pvt)[colnames(OZ_st_pvt) != "Date"]
puntajes <- as.data.frame(puntaje) 
coordinates(puntajes) <- OZ_stations[,c("X", "Y")]

puntaje <- data.frame(puntaje, puntajes@coords)

Tendencia en las componentes

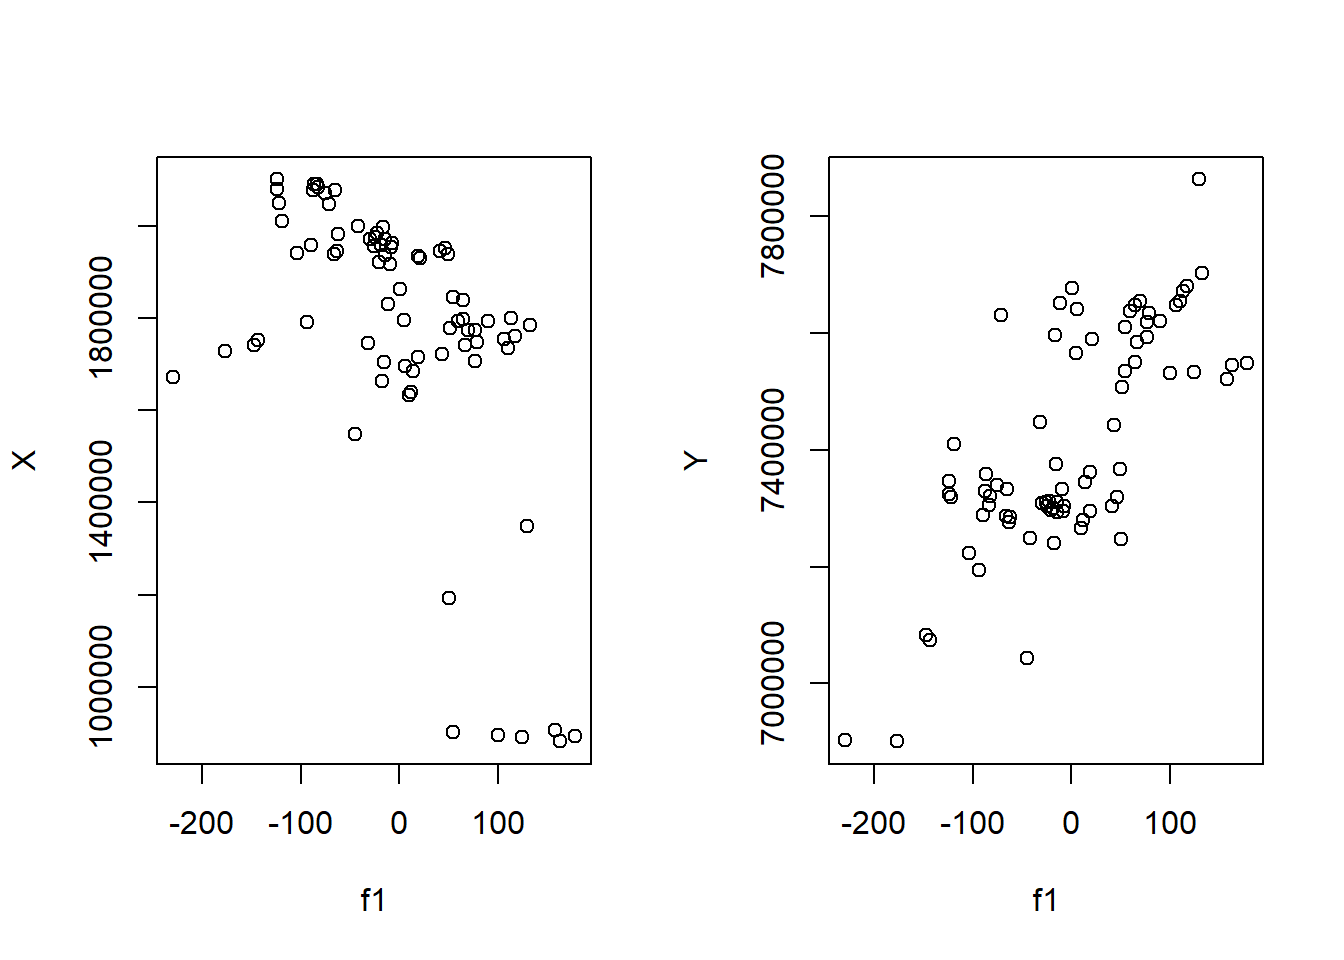
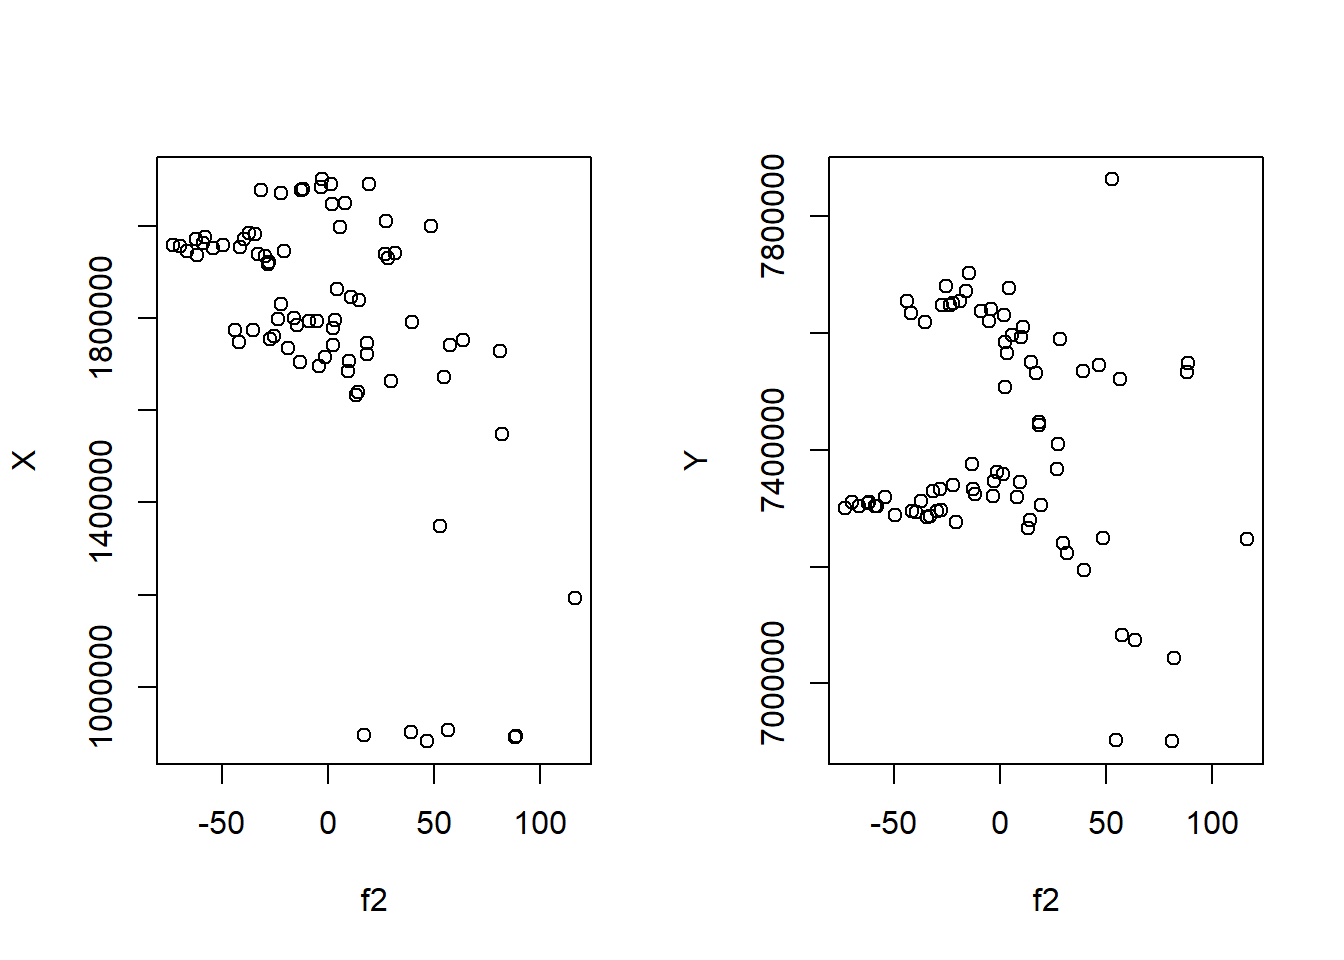
Ahora, analizamos la tendencia de las dos primeras componentes principales funcionales.

par(mfrow = c(1,2))
plot(puntajes$f1, puntajes@coords[,"X"],
     xlab = "f1", ylab = "X")
plot(puntajes$f1, puntajes@coords[,"Y"],
     xlab = "f1", ylab = "Y")

par(mfrow = c(1,2))
plot(puntajes$f2, puntajes@coords[,"X"],
     xlab = "f2", ylab = "X")
plot(puntajes$f2, puntajes@coords[,"Y"],
     xlab = "f2", ylab = "Y")

Como se puede apreciar, los scores no presentan estacionariedad con respecto a la media. Por lo tanto, se intenta ajustar un modelo tal que ahora sí lo sean.

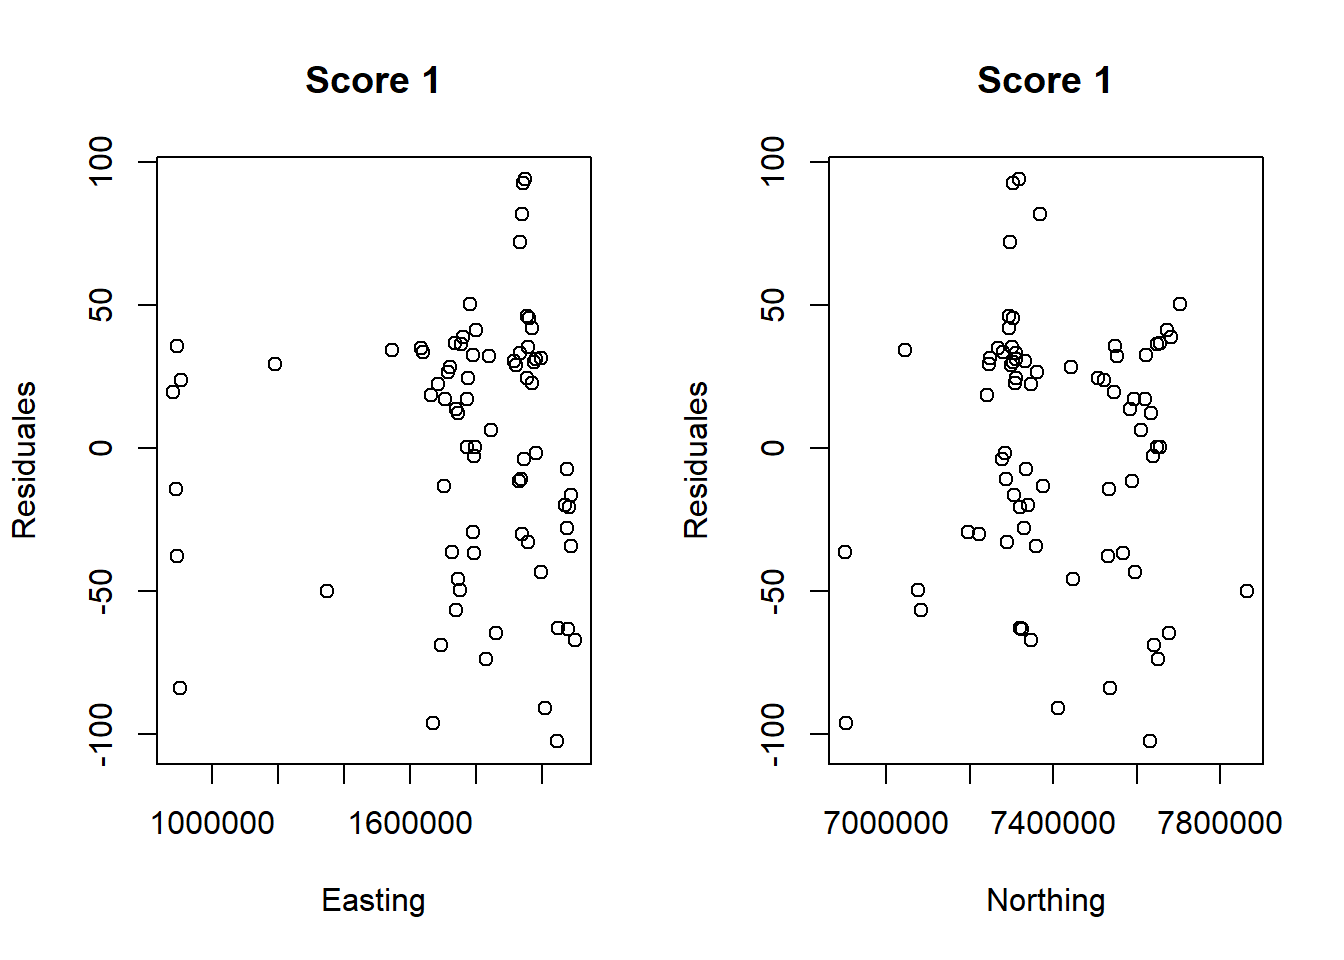
Para el primer scores, el mejor modelo que se ajustó fue

\[\text{score}_i^1 = \beta_0 + \beta_1x + \beta_2y\] Mientras que para el segundo, se obtuvo el modelo

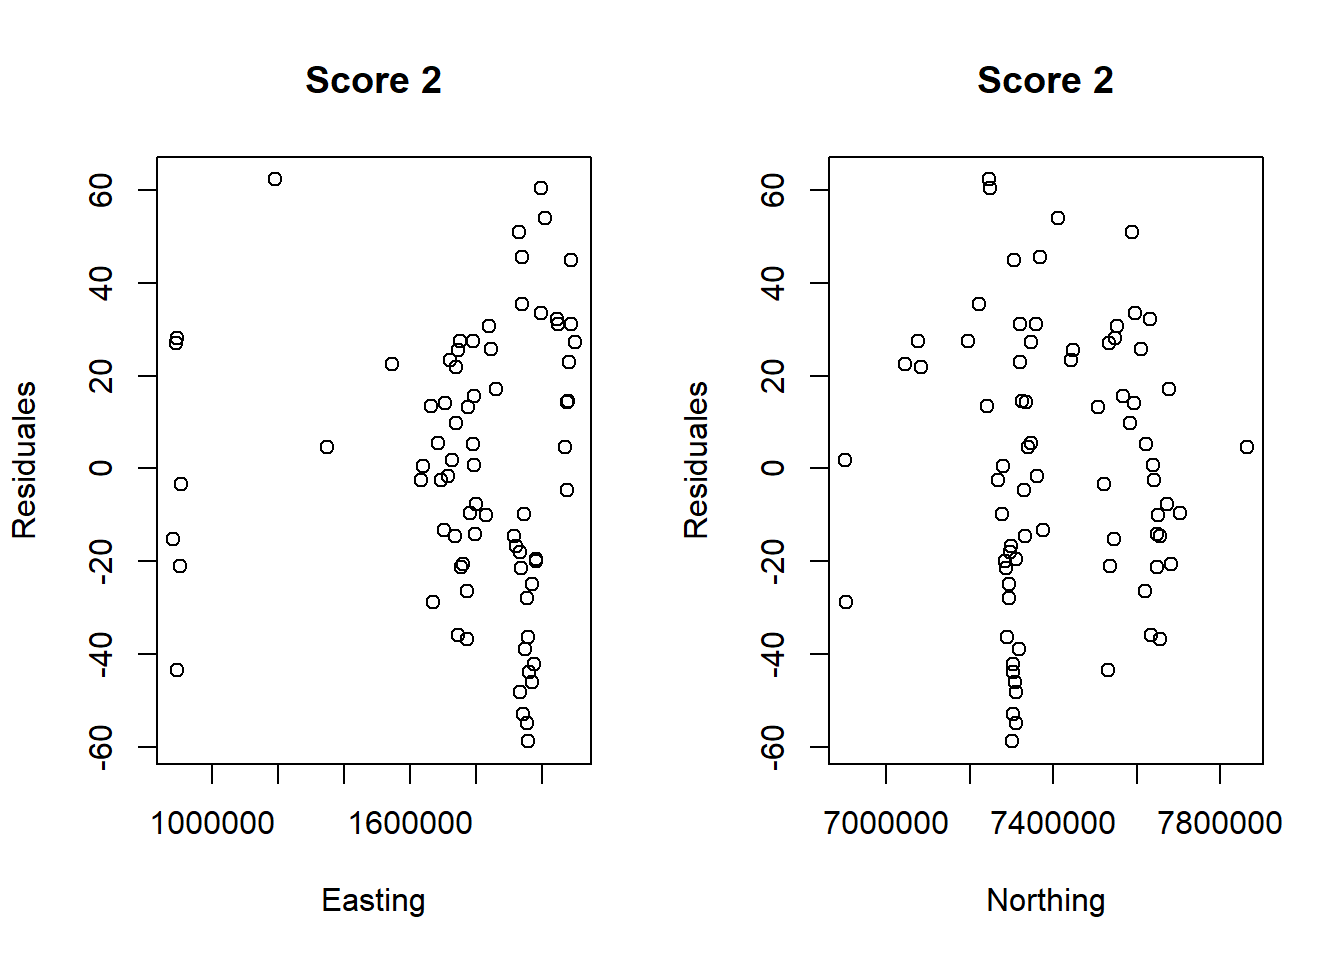
\[\text{score}_i^2 = \beta_0 + \beta_1x + \beta_2y + \beta_3y^2\]

De esta forma,

fit.f1 <- lm(f1 ~ X + Y, data = puntaje)

puntaje$f1res <- resid(fit.f1)

par(mfrow = c(1,2))

plot(resid(fit.f1) ~ puntaje$X,
     xlab = "Easting", ylab = "Residuales", main = "Score 1")
plot(resid(fit.f1) ~ puntaje$Y,
     xlab = "Northing", ylab = "Residuales", main = "Score 1")

fit.f2 <- lm(f2 ~ X + poly(Y, 2), data = puntaje)

puntaje$f2res <- resid(fit.f2)

par(mfrow = c(1,2))
plot(resid(fit.f2) ~ puntaje$X,
     xlab = "Easting", ylab = "Residuales", main = "Score 2")
plot(resid(fit.f2) ~ puntaje$Y,
     xlab = "Northing", ylab = "Residuales", main = "Score 2")

De esta forma, se puede ver que ahora sí hay estacionariedad al trabajar con los residuales de los modelos ajustados para cada score. De esta forma, ahora es posible encontrar los modelos de semivarianza que mejor se ajusten a los semivariogramas empíricos de los scores.

Semivariogramas

Primero creamos el objeto gstat para luego obtener los semivariogramas de los scores y así, poder ajustar modelos teóricos.

f1.vgm <- variogram(f1 ~ X + Y, puntajes)

f2.vgm <- variogram(f2 ~ X + poly(Y, 2), puntajes)


fd.v.cross <- gstat(NULL, id = "f1", form = f1 ~ X + Y, data = puntajes)
fd.v.cross <- gstat(fd.v.cross, id = "f2", form = f2 ~ X + poly(Y, 2), data = puntajes)

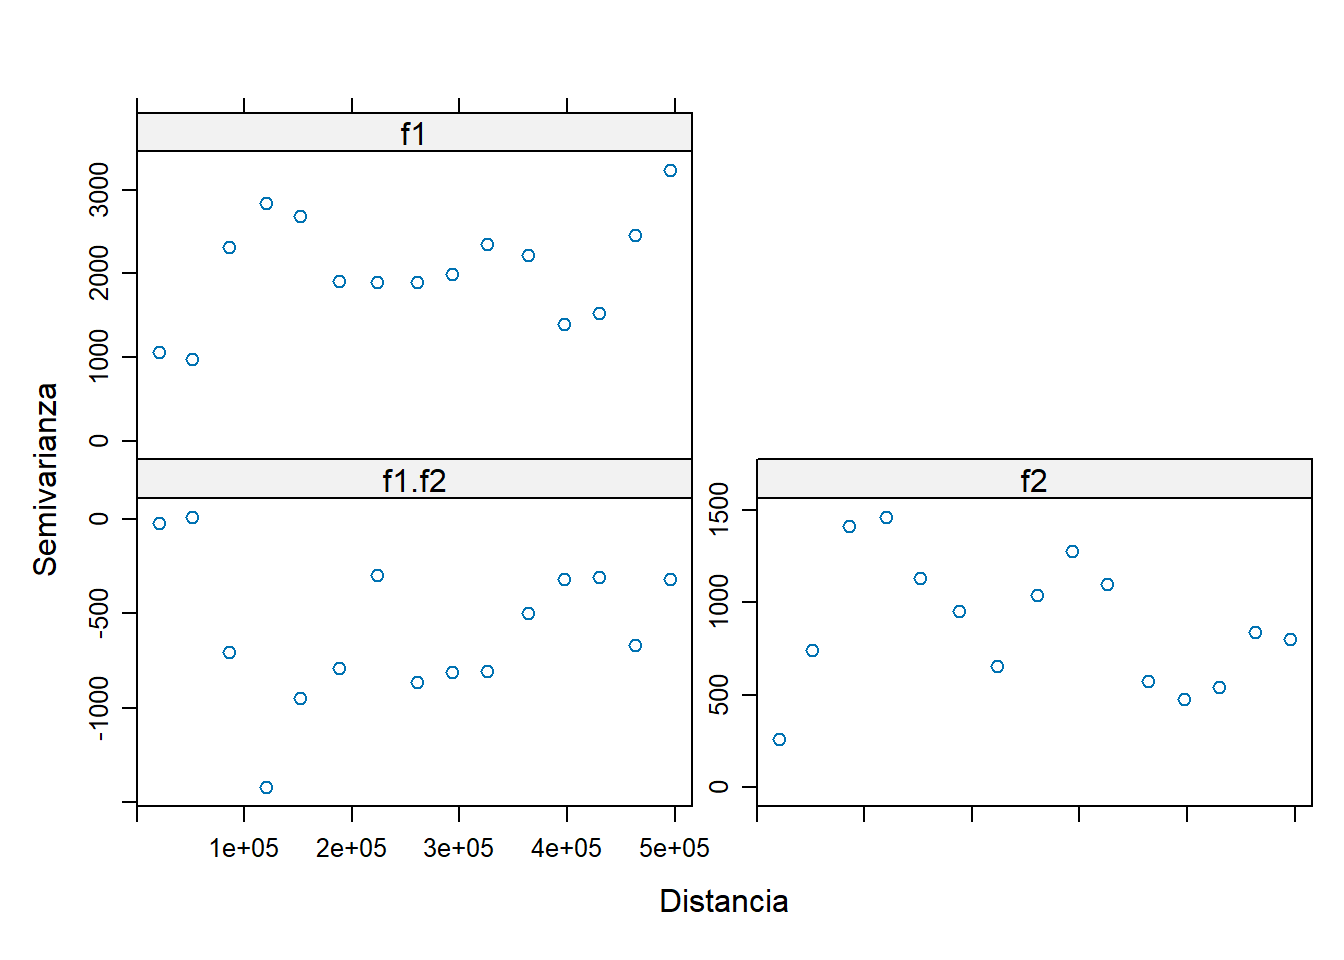
vgm.cross <- variogram(fd.v.cross)
plot(vgm.cross, xlab = "Distancia", ylab = "Semivarianza")

Estimación Teórica de los Semivariogramas

Primero, con ayuda de eyefit, obtenemos algunos modelos potencias y valores iniciales para proceder con la estimación de los parámetros.

f1

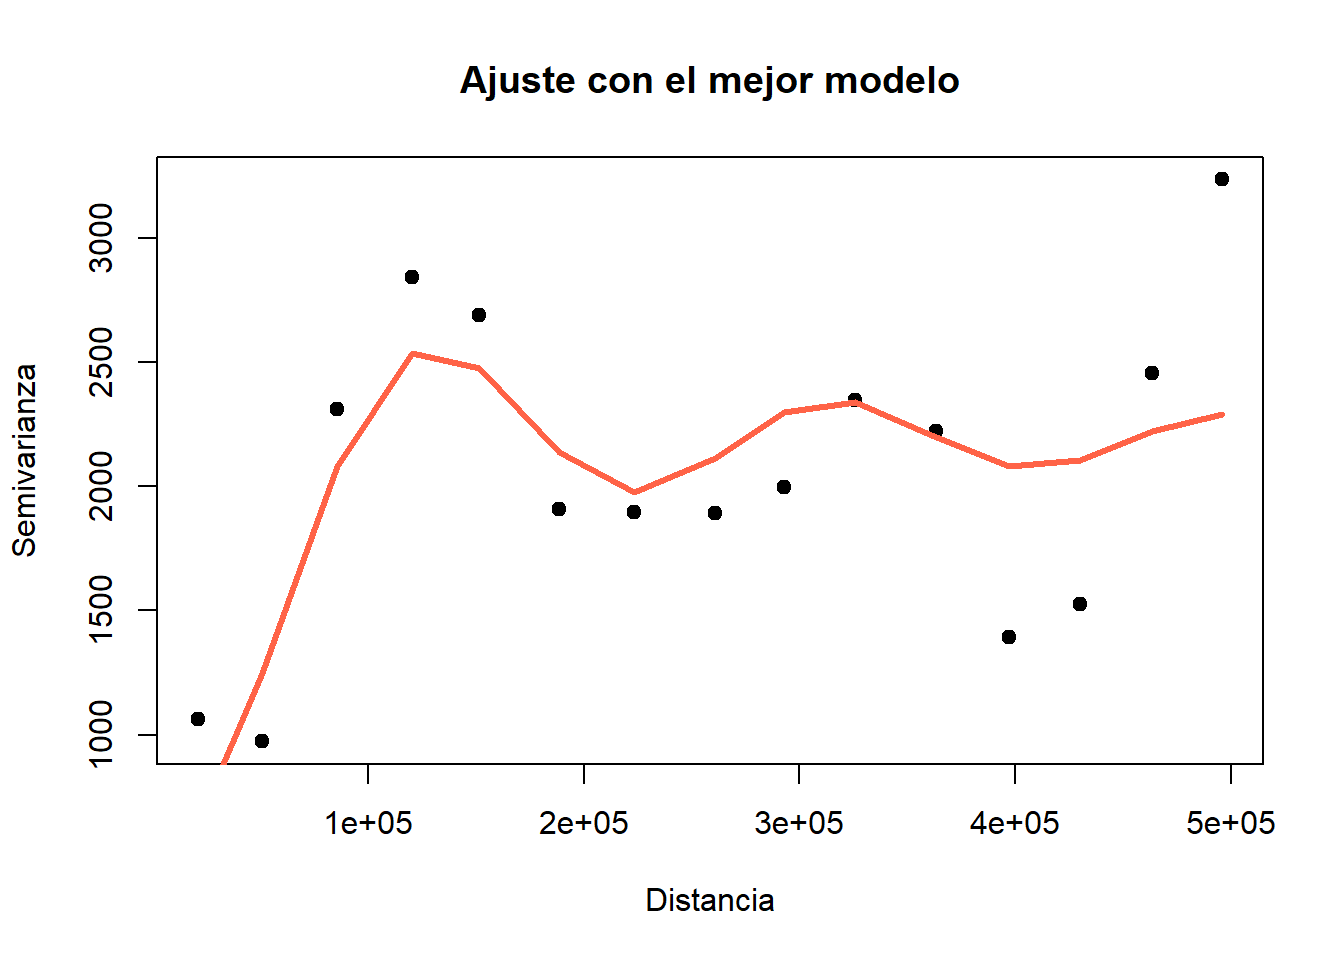
Para el primer score, se halló que los potenciales modelos son dos: Gausiano y Wave. Se presentan sus valores iniciales.

Code
# Gausiano
init_gau <- c(c0 = 241.88, cs = 2338.16, a = 60034.02)
 
# Wave
init_wav <- c(c0 = 322.5, cs = 2015.65, a = 30017.01)
gamma_gaus <- function(h, c0, cs, a){
  ifelse(h == 0,
         0,
         c0 + cs*(1 - exp(-(h/a)^2)))
}

gamma_wave <- function(h, c0, cs, a){
  ifelse(h == 0,
         0,  
         c0 + cs * (1 - (sin(h/a) / (h/a))))
}

MSE <- function(fitted, observed){
  
  mean((fitted - observed)^2)
  
}


data <- data.frame(h = f1.vgm$dist,
                   gamma_hat = f1.vgm$gamma,
                   n = f1.vgm$np)

Se ajustan los modelos mediante las funciones nls y nlsLM. Se obtienen los siguientes resultados:

nls.gaus1 <- nls(gamma_hat ~ gamma_gaus(h, c0, cs, a),
                 data = data,
                 start = as.list(init_gau),
                 algorithm = "port",
                 lower = c(0, 0, 0))

ctrl <- nls.control(maxiter = 1000, tol = 1e-10, minFactor = 1/1024)
nls.gaus2 <- nlsLM(gamma_hat ~ gamma_gaus(h, c0, cs, a),
                   data = data,
                   start = as.list(init_gau),
                   weights = n,
                   control = ctrl,
                   lower = c(0, 0, 0))

nls.gaus3 <- nlsLM(gamma_hat ~ gamma_gaus(h, c0, cs, a),
                   data = data, 
                   start = as.list(init_gau),
                   weights = (n/h^2),
                   control = nls.lm.control(maxiter=1000, ftol=1e-10, ptol=1e-10),
                   lower = c(0, 0, 0))


nls.wave1 <- nls(gamma_hat ~ gamma_wave(h, c0, cs, a),
                 data = data,
                 start = as.list(init_wav))


nls.wave3 <- nls(gamma_hat ~ gamma_wave(h, c0, cs, a),
                 data = data,
                 start = as.list(init_wav), 
                 algorithm = "port",
                 lower = c(0, 0, 0), 
                 weights = (n/h^2))
MSE para cada modelo y peso
Modelo MSE Peso
Gausiano 243089.9 \(1\)
Gausiano 248831.4 \(n\)
Gausiano 294734.9 \(\frac{n}{h^2}\)
Wave 159914.7 \(1\)
Wave 227581.0 \(\frac{n}{h^2}\)

De esta forma, vemos que el que mejor ajustó fue el modelo Wave sin pesos. Observemos este modelo con los parámetros estimados.

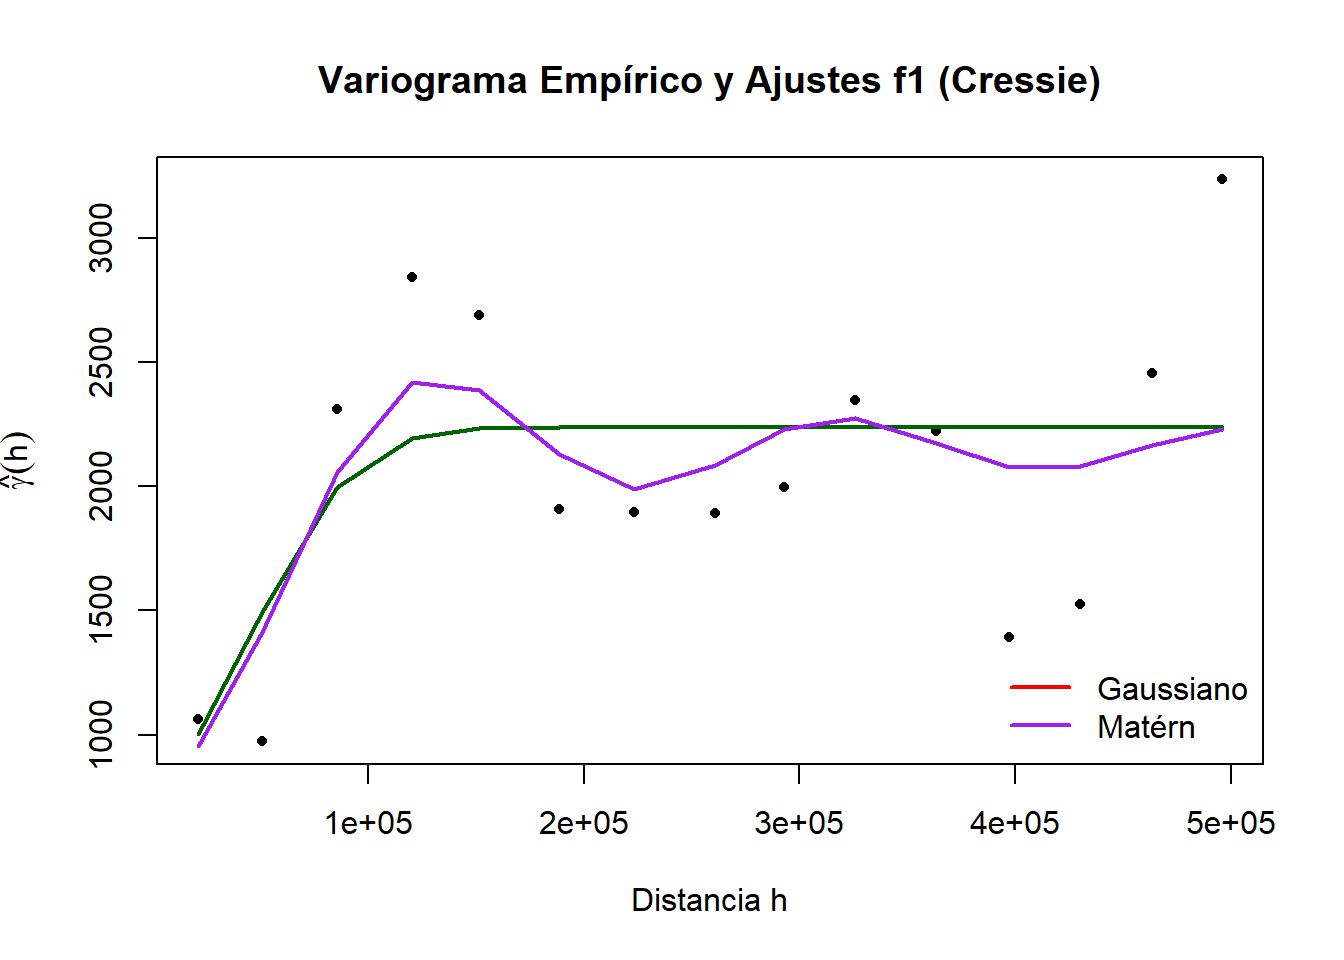
Se prueba el método de estimación Cressie con la matriz de pesos cambiando en cada iteración:

Code
Q_cressie <- function(par, data, gamma_fun, kappa = NULL, eps = 1e-12){
  
  g <- if (is.null(kappa)) {
    gamma_fun(h = data$h, c0 = par["c0"], cs = par["cs"], a = par["a"])
    
  } else {
    
    gamma_fun(h = data$h, c0 = par["c0"], cs = par["cs"], a = par["a"], kappa = kappa)
    
  }
  
  g2 <- pmax(g^2, eps)         
  
  sum( data$n * (data$gamma_hat - g)^2 / (2 * g2), na.rm = TRUE )
}


fit_cressie <- function(gamma_fun, start, data,
                        lower = c(c0=0, cs=0, a=.Machine$double.eps),
                        upper = c(c0=Inf, cs=Inf, a=Inf),
                        kappa = NULL){
  
  par0 <- start[c("c0","cs","a")]    
  
  opt <- optim(par = par0, fn = Q_cressie, method = "L-BFGS-B",
               lower = lower, upper = upper,
               data = data, gamma_fun = gamma_fun, kappa = kappa)
  
  
  p  <- opt$par
  
  g  <- if (is.null(kappa)) {
    gamma_fun(data$h, p["c0"], p["cs"], p["a"])
  } else {
    gamma_fun(data$h, p["c0"], p["cs"], p["a"], kappa)
  }    
  
  mse <- MSE(g, data$gamma_hat)
  
  list(par = p, converged = (opt$convergence==0),
       fitted = g, MSE = mse, kappa = kappa)
}

Y se realiza el ajuste de los modelos.

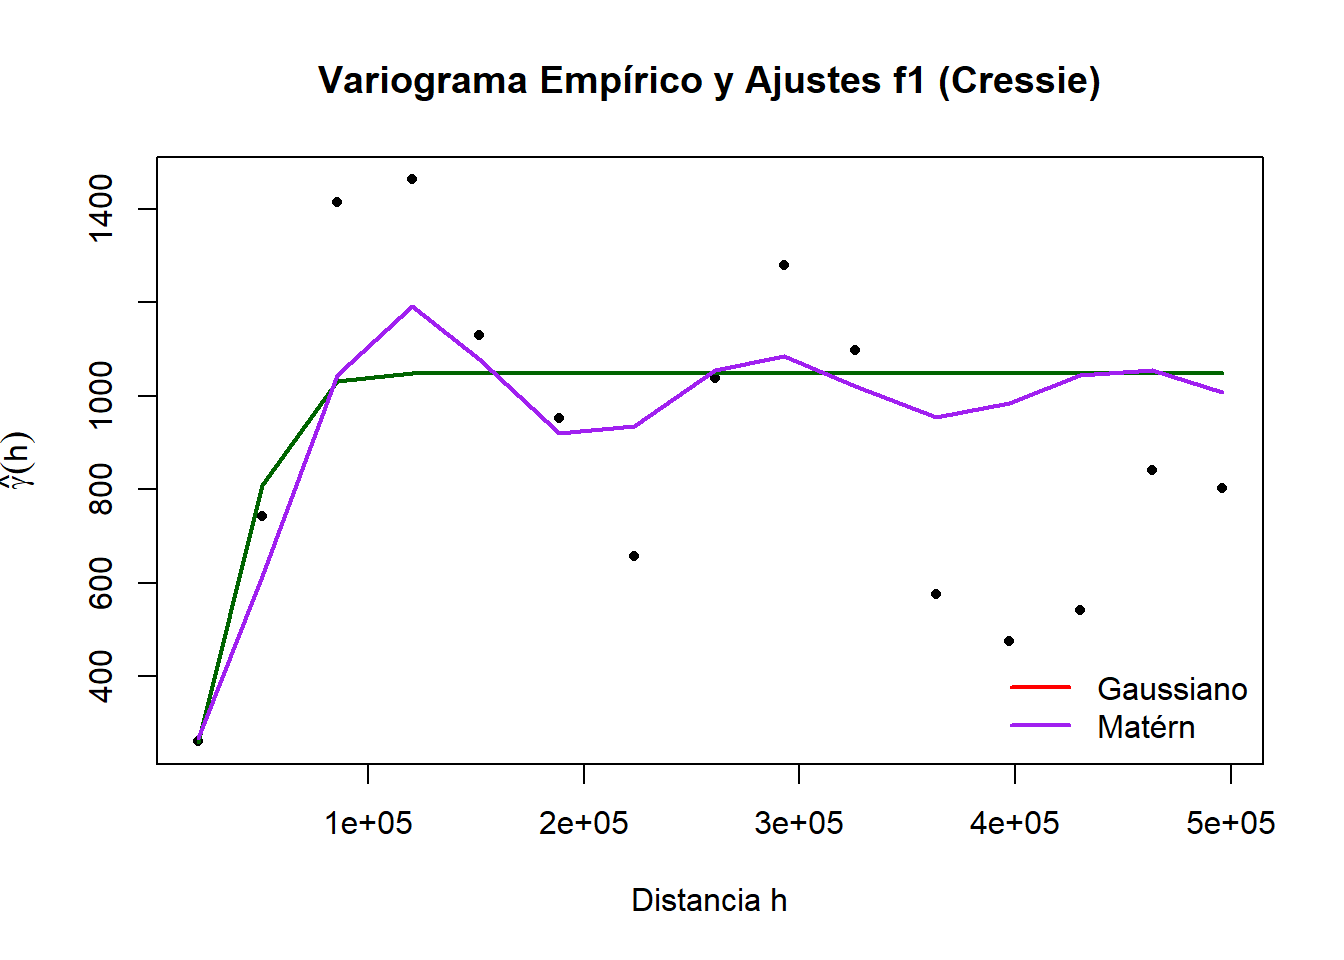
cress.gaus <- fit_cressie(gamma_gaus, start = init_gau, data = data)

cress.wave <- fit_cressie(gamma_wave, start = init_wav, data = data)

MSE para ajustes Cressie
Modelo MSE
Gausiano 245898.6
Wave 170948.1

De esta forma, se observa que se siguen teniendo mejores resultados con el método de regresión no lineal.

f2

De nuevo, con ayuda de eyefit se encuentra que los modelos con una mayor similitud al semivariograma empírico son el Gausiano y el Wave. Se inicializan los parámetros en:

Code
# Gausiano
init_gau <- c(c0 = 148.02, cs = 1040.17, a = 46693.13)

# Wave
init_wav <- c(c0 = 148.02, cs = 1040.17, a = 31128.75)

Se ajustan los modelos mediante regresión no lineal.

data <- data.frame(h = f2.vgm$dist,
                   gamma_hat = f2.vgm$gamma,
                   n = f2.vgm$np)

nls.gaus1 <- nls(gamma_hat ~ gamma_gaus(h, c0, cs, a),
                 data = data,
                 start = as.list(init_gau),
                 algorithm = "port",
                 lower = c(0, 0, 0))

ctrl <- nls.control(maxiter = 1000, tol = 1e-10, minFactor = 1/1024)
nls.gaus2 <- nlsLM(gamma_hat ~ gamma_gaus(h, c0, cs, a),
                   data = data,
                   start = as.list(init_gau),
                   weights = n,
                   control = ctrl,
                   lower = c(0, 0, 0))

nls.gaus3 <- nlsLM(gamma_hat ~ gamma_gaus(h, c0, cs, a),
                   data = data, 
                   start = as.list(init_gau),
                   weights = (n/h^2),
                   control = nls.lm.control(maxiter=1000, ftol=1e-10, ptol=1e-10),
                   lower = c(0, 0, 0))


nls.wave1 <- nls(gamma_hat ~ gamma_wave(h, c0, cs, a),
                 data = data,
                 start = as.list(init_wav))

nls.wave2 <- nls(gamma_hat ~ gamma_wave(h, c0, cs, a),
                 data = data,
                 start = as.list(init_wav), 
                 weights = 1/n,
                 algorithm = "port",
                 lower = c(0, 0, 0))


nls.wave3 <- nls(gamma_hat ~ gamma_wave(h, c0, cs, a),
                 data = data,
                 start = as.list(init_wav), 
                 algorithm = "port",
                 lower = c(0, 0, 0), 
                 weights = (n/h^2))
Obteniendo los siguientes resultados:

MSE para cada modelo y peso
Modelo MSE Peso
Gaussiano 87114.72 \(1\)
Gaussiano 87367.20 \(n\)
Gaussiano 154793.73 \(\frac{n}{h^2}\)
Wave 68123.90 \(1\)
Wave 68553.19 \(n\)
Wave 118020.07 \(\frac{n}{h^2}\)

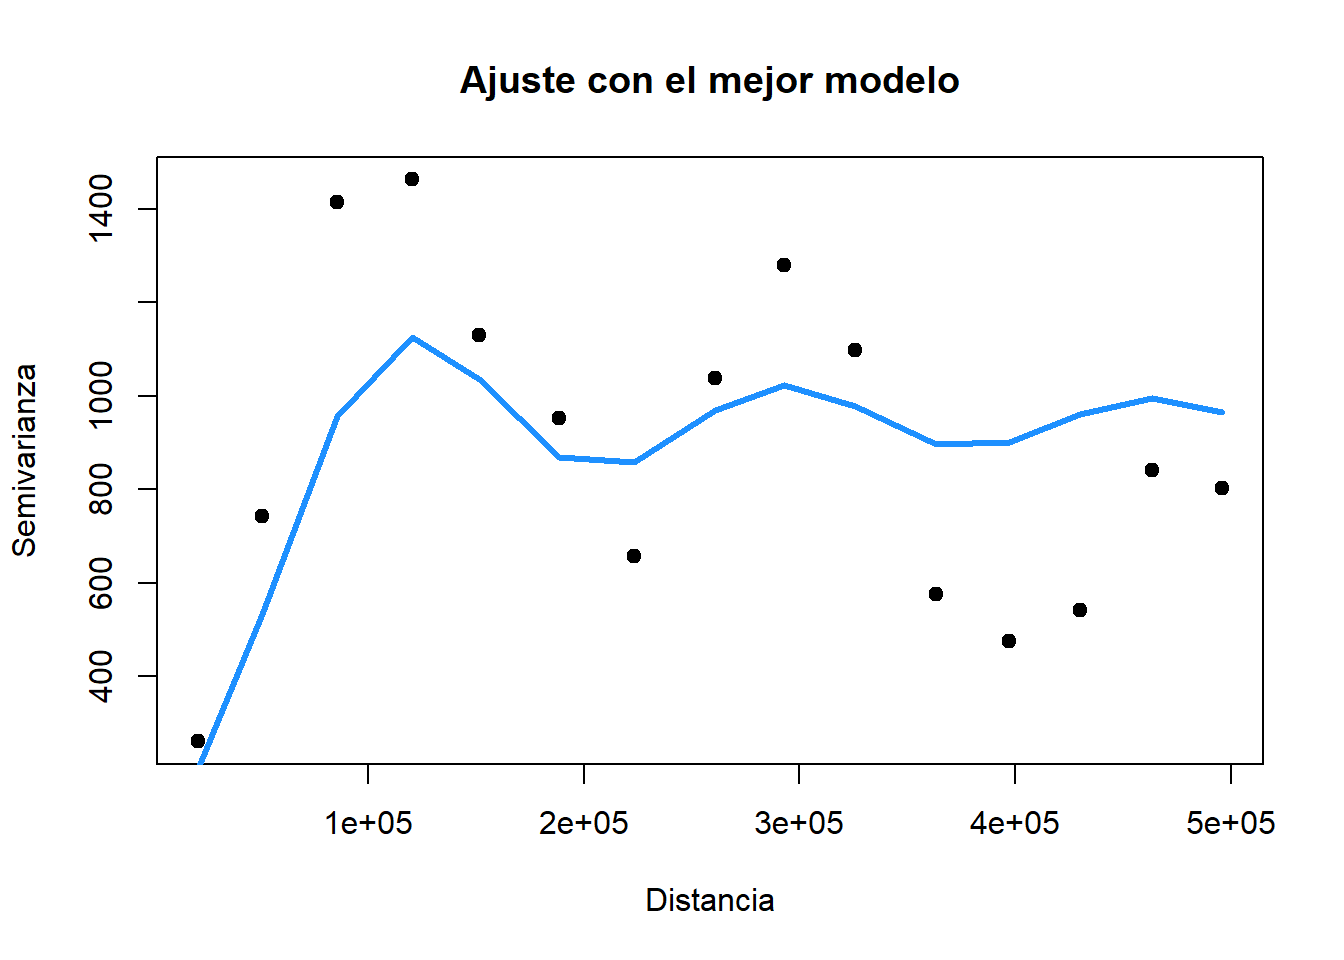
Encontrando una vez más que, el mejor modelo corresponde al Wave sin considerar pesos en la estimación.

plot(f2.vgm$dist, f2.vgm$gamma,
     pch = 19, xlab = "Distancia", ylab = "Semivarianza",
     main = "Ajuste con el mejor modelo")
lines(x = data$h, y = fitted(nls.wave1),
      col = "dodgerblue", lwd = 3) # el mejor de todos

f2.model <- list(par = coef(nls.wave1),
                 model = "Wav")

De esta forma, ya se tiene el ajuste de los modelos teróricos para cada score.

Se prueba además, con otro método de estimación.

cress.gaus <- fit_cressie(gamma_gaus, start = init_gau, data = data)

cress.wave <- fit_cressie(gamma_wave, start = init_wav, data = data)

MSE para ajustes Cressie
Modelo MSE
Gausiano 97228.47
Wave 73001.86

Obteniendo un mejor ajuste por el método de Cressie apra el modelo Wave.

Kriging Funcional: Scores

Ya obtenidos los modelos se modifica el objeto gstat que se había definido anteriormente basado en las modelos ajustados.

Code
fd.v.cross <- gstat(fd.v.cross, id = "f1", 
                    model = vgm(1691.1, "Wav", 3*28992.4, 502.2), 
                    fill.all = FALSE)

fd.v.cross <- gstat(fd.v.cross, id = "f2", 
                    model = vgm(831.2681, "Wav", 3*26174.5293, 180.7270), 
                    fill.all = FALSE)

De esta forma, ahora definimos un nuevo objeto SpatFD y se usa la función KS_scores_lambdas. Luego, con reconstruimos las curvas, obteniendo las predicciones en los lugares no muestreados:

Code
grid <- read.csv("grid.csv", check.names = FALSE)


spat_fd <- SpatFD(data = OZ.matrix, coords = OZ_stations[,c("X", "Y")],
                  basis = "Bsplines", nbasis = nbasis,
                  lambda = best.lambda, nharm = 2)

KS_sco <- KS_scores_lambdas(spat_fd, newcoords = grid, model = fd.v.cross$model,
                            method = "scores")
Using first variable by default
Using fill.all = TRUE by default
Code
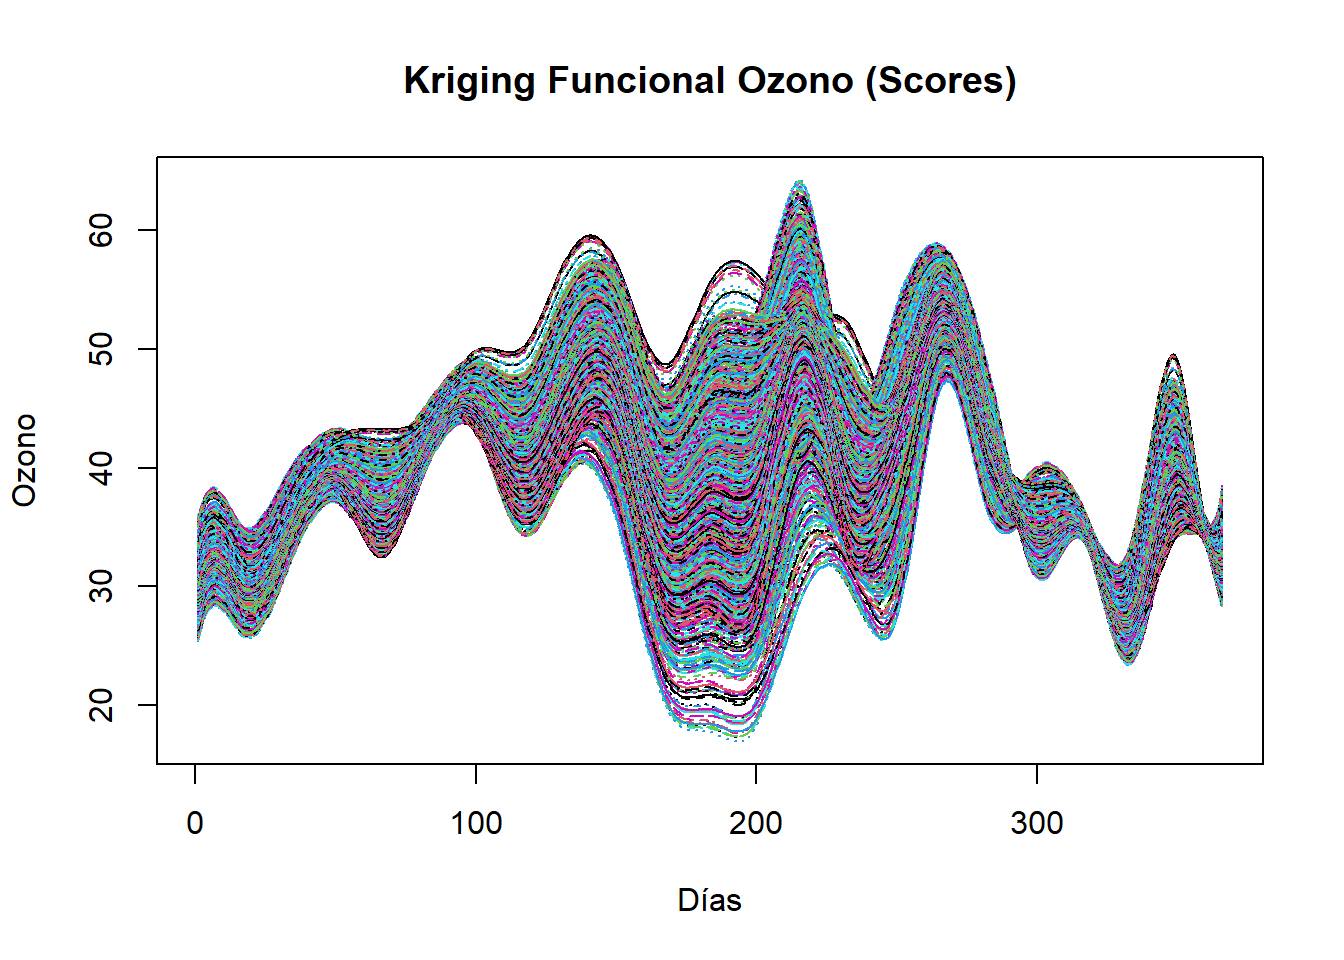
curves_sco <- recons_fd(KS_sco)

plot(curves_sco, main = "Kriging Funcional Ozono (Scores)", 
     xlab = "Días", ylab = "Ozono")

Se puede observar que las curvas reconstruidas mediante el kriging por el método de scores en los lugares no muestreados conservan los comportamientos temporales de las estaciones reales.

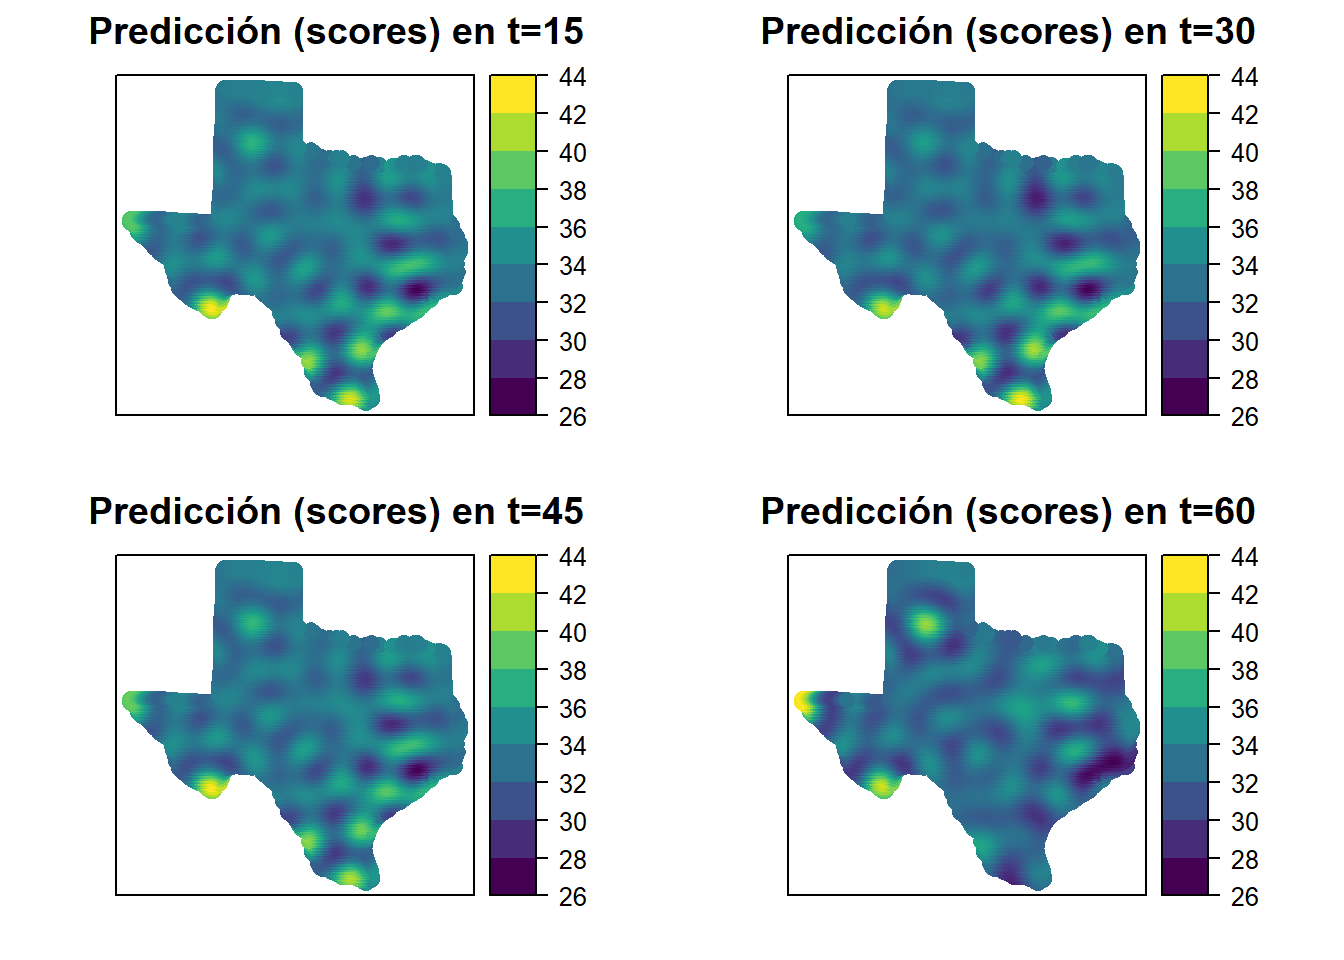
Para obtener las sucesiones de superficies espaciales, se consideran cuatro fechas en específico, espaciadas temporalmente quince días.

eval <- fda::eval.fd(1:366, curves_sco) # Matriz Predicciones

tiempos <- c(15, 30, 45, 60)

# 1) Obtener rango global de todos los valores
valores <- unlist(eval[tiempos, ])   # valores de los tiempos
rng_global <- range(valores, na.rm = TRUE)
at_lab <- pretty(rng_global, n = 10)


plots.fd <- list()
k <- 1

par(mfrow=c(2,2))
for (t in c(15, 30, 45, 60)) {
  fd.pred <- data.frame(coordinates(grid), Ozone = eval[t,]) # Cada fecha
  coordinates(fd.pred) <- ~ X + Y


  p.fd <- spplot(fd.pred, "Ozone", colorkey = list(
                  right = list(
                    fun = draw.colorkey,
                    args = list(
                      key = list(
                        at = at_lab,
                        col = viridis(100),
                        labels = list(at = at_lab)
                      )
                    )
                  )
                ), 
                col.regions = viridis(100),
                main = paste0("Predicción (scores) en t=",t))
  
  plots.fd[[k]] <- p.fd
  k <- k + 1
}


gridExtra::grid.arrange(grobs = plots.fd, nrow = 2, ncol = 2)

De estas gráficas es posible ver que los patrones espaciales son similares a través del tiempo, teniendo temperaturas más altas hacia el noroccidente y el sur de Texas, mientras que los valores más bajos de temperatura se pueden observar hacie el oriente.